AgentForesight: Online Auditing for Early Failure Prediction in Multi-Agent Systems
主要贡献:把多智能体失败分析从"事后全知归因"重构为在线审计——审计器仅凭已执行前缀 \tau_{0:k},在每一步输出 Continue 或 Alarm(步号+责任 agent),从而在决定性错误向后传播前打开干预窗口。 创新点:① 提出决定性错误的形式化定义与在线审计模型,并自建 AFTraj-2K 语料(严格过滤的安全轨迹提供前缀级正类监督 + 构造注入与多评委投票的步级标注);② 设计由粗到细的训练配方(BPPO 边界对偏好优化对齐失败边界 → GRPO 三轴奖励锐化步级定位),7B 模型即以 66.44 Exact-F1 超越最强专有基线 19.88 分,并首次进入可部署区域(FAR 2.4%、Step-Acc 59.5%)。
标题:AgentForesight: Online Auditing for Early Failure Prediction in Multi-Agent Systems(AgentForesight:面向多智能体系统早期失败预测的在线审计) 作者:Boxuan Zhang(Rutgers University,共同一作)、Jianing Zhu(The University of Texas at Austin,共同一作)、Zeru Shi(Rutgers University)、Dongfang Liu(Purdue University)、Ruixiang Tang(Rutgers University,通讯作者) 发布日期:2026 年 5 月 9 日(v1 提交),2026 年 5 月 13 日修订(v2) 投稿信息:NeurIPS 2026
代码仓库:github.com/ZBox1005/AgentForesight;数据集 huggingface.co/datasets/ZBox008003/AFTraj;项目页 zbox1005.github.io/agent-foresight。模型权重在项目页上未见公开链接。
研究动机
问题
现在的多智能体处理长程任务时,如果前置出现决定性错误,容易被后续agent视作前提条件,并在错误的基础上继续执行,最终导致失败;
这类失败在接入 API 与外部服务的真实部署中不只是"benchmark 准确率下降",而会带来不可逆的副作用(文件写入、外部请求),因此可靠性成为多智能体系统部署的核心瓶颈;
现有范式
现有的工作把这当作事后归因问题,在任务最终失败以后,回溯执行轨迹,诊断责任主体和步骤。
- Who&When(ICML 2025):利用完整失败轨迹搜索导致任务失败的关键agent和步骤;提出决定性错误的定义:纠正该错误能够使原本的失败的轨迹执行成功;提出责任归因和关键步骤定位;并 benchmark 了 all-at-once、step-by-step、binary-search 三种提示策略。
- AgenTracer:(ICLR 2026)也是针对责任归因和决定性错误定位,利用 反事实重放:改变agent某个步骤行为,看能否修正;以及 程序化故障注入 修改成功轨迹,制造失败构建数据集;训练 AgenTracer-8B,在全轨迹上使用多粒度奖励。
- AgentDebug:(2025 年)建立系统化的 Agent 错误分类体系,给出 memory / reflection / planning / action / system 五模块错误分类,构建 AgentErrorBench 错误轨迹数据集;AgentDebug详细分析执行轨迹,定位错误,然后生成纠正反馈并重新执行;
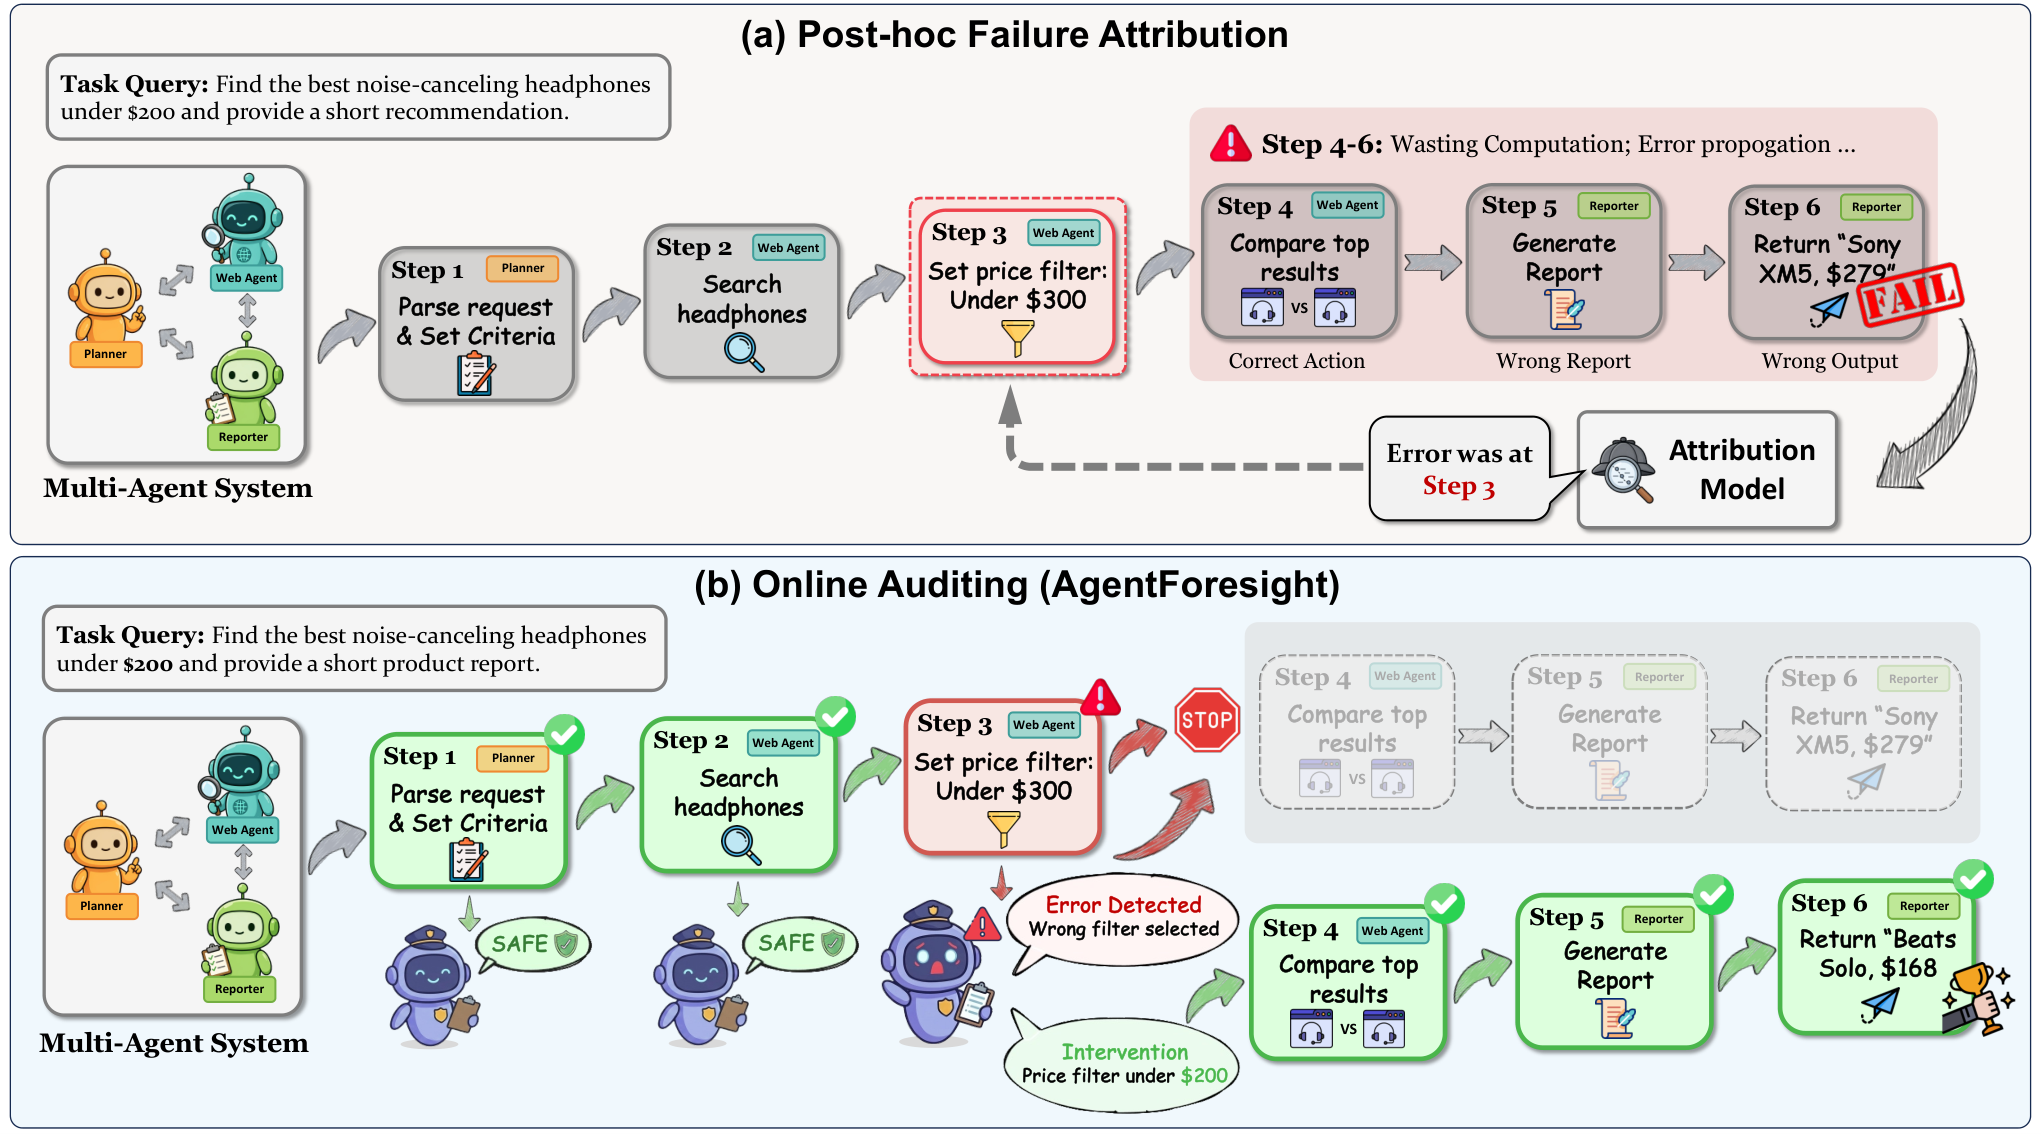
现有方法的三个决定性限制
- 需要拥有对完整轨迹 τ 与终局标签 Ω(τ)=0 的全知视角;
- 针对整个轨迹一次性输出单个预测 (\hat k, \hat a),无法每一步及时预测;
- 预测发生在失败已经发生之后,没有干预窗口。
作者提出问题:能否审计执行轨迹的前缀,在失败向后传播前发现决定性错误?
实现这个目的需要引入在线审计 online auditing,不依赖后续步骤的情况下,对每个已经执行步骤进行判断;审计器在每一步只看 \tau_{0:k},在"继续"与"报警"之间做选择,看不到未来步、工具返回和最终结果。这与事后归因在三条性质上正好相反:信息从前缀受限替代全知、输出从一次变成每步一次、Alarm 在 t_{k+1} 提交前创造干预窗口。
要求:
- 它必须可靠地区分仍然安全的前缀与已经越过决定性错误的前缀;
- 它必须在错误发生的当步作出判定,而非事后回溯;
方法
问题建模
多智能体执行被建模成回合制系统 \mathcal{M}=(\mathcal{S},\mathcal{N},\pi_{\text{sys}},\Psi,\Omega),其可观测轨迹是一串回合 \tau=(t_{0},\ldots,t_{N-1}),每个回合 t_{i}=(\mathrm{role}_{i},\mathrm{action}_{i},\mathrm{content}_{i})。\Omega是一个判断是否成功的二元函数;
- \mathcal{S}:系统状态集合;
- \mathcal{N}:有限的 agent 角色集合(如 Planner、WebAgent、CodeWriter);
- \pi_{\text{sys}}:给定当前状态产生下一 turn 的系统策略;
- \Psi:状态更新函数;
- \Omega:\mathcal{T}\to\{0,1\}:对已完成轨迹按任务规范给出的二值结果函数(1 成功 / 0 失败),\mathcal{T} 为有限轨迹空间。
- (\mathrm{action}_i,\mathrm{content}_i) 记录动作及其可观测结果。
决定性错误
失败分析的操作单元取"决定性错误":修正它就能把结果从失败翻成成功的那个最早步骤。
- \tilde{t}:一个 "可采纳的修正回合";
- {T}:轨迹的步索引集合,T=N。
- {\mathcal{T}_{k}(\tau_{0:k-1})}:在位置 k 上所有"可接受的正确回合",即反事实替换的候选集。
- {\mathcal{R}_{\mathcal{M}}(\cdot)}:给定修正后的前缀、在系统策略 \pi_{\text{sys}} 下可达的后缀轨迹集合。
- {\Omega(\tau)}:二元结果函数,\Omega=1 为成功、0 为失败,由任务规格判定。
这个定义的重点在"最早"和"不可恢复":
- k^{*} 是最早一步,其错误无法被任何下游 rollout 挽回,因而在该步做 oracle 修正是既必要又充分的。
- 责任人 a^{*}=\mathrm{role}_{k^{*}},失败轨迹标注 (k^{*},a^{*}),成功轨迹标注 (\text{Safe},\emptyset)。
在线审计模型
在0-k的每一步上应用,如果报告continue,表示观察窗口内尚未观察到决定性错误;而Alarm判定则会停止执行,报告决定性错误的步骤,以及对此需要负责的agent N
AFTraj- 2K 语料库构建
在线审计对语料的要求比事后归因苛刻,具体是三件事:
- 针对不安全轨迹,具有步级的真实标签( k ^∗ , a ^∗ );
- 有验证过的安全轨迹以提供前缀级正类监督;
- 覆盖异构多智能体框架与任务领域;
现有数据集:
- Who&When :提供步骤级决定性错误标注,但是但仅包含失败轨迹;
- ATBench:同时包含安全和不安全轨迹,但是仅提供轨迹级标签;
因此作者自建 AFTraj-2K,共 2,272 条 family 级轨迹(安全 1,158 / 失败 1,114),平均 11.5 回合。
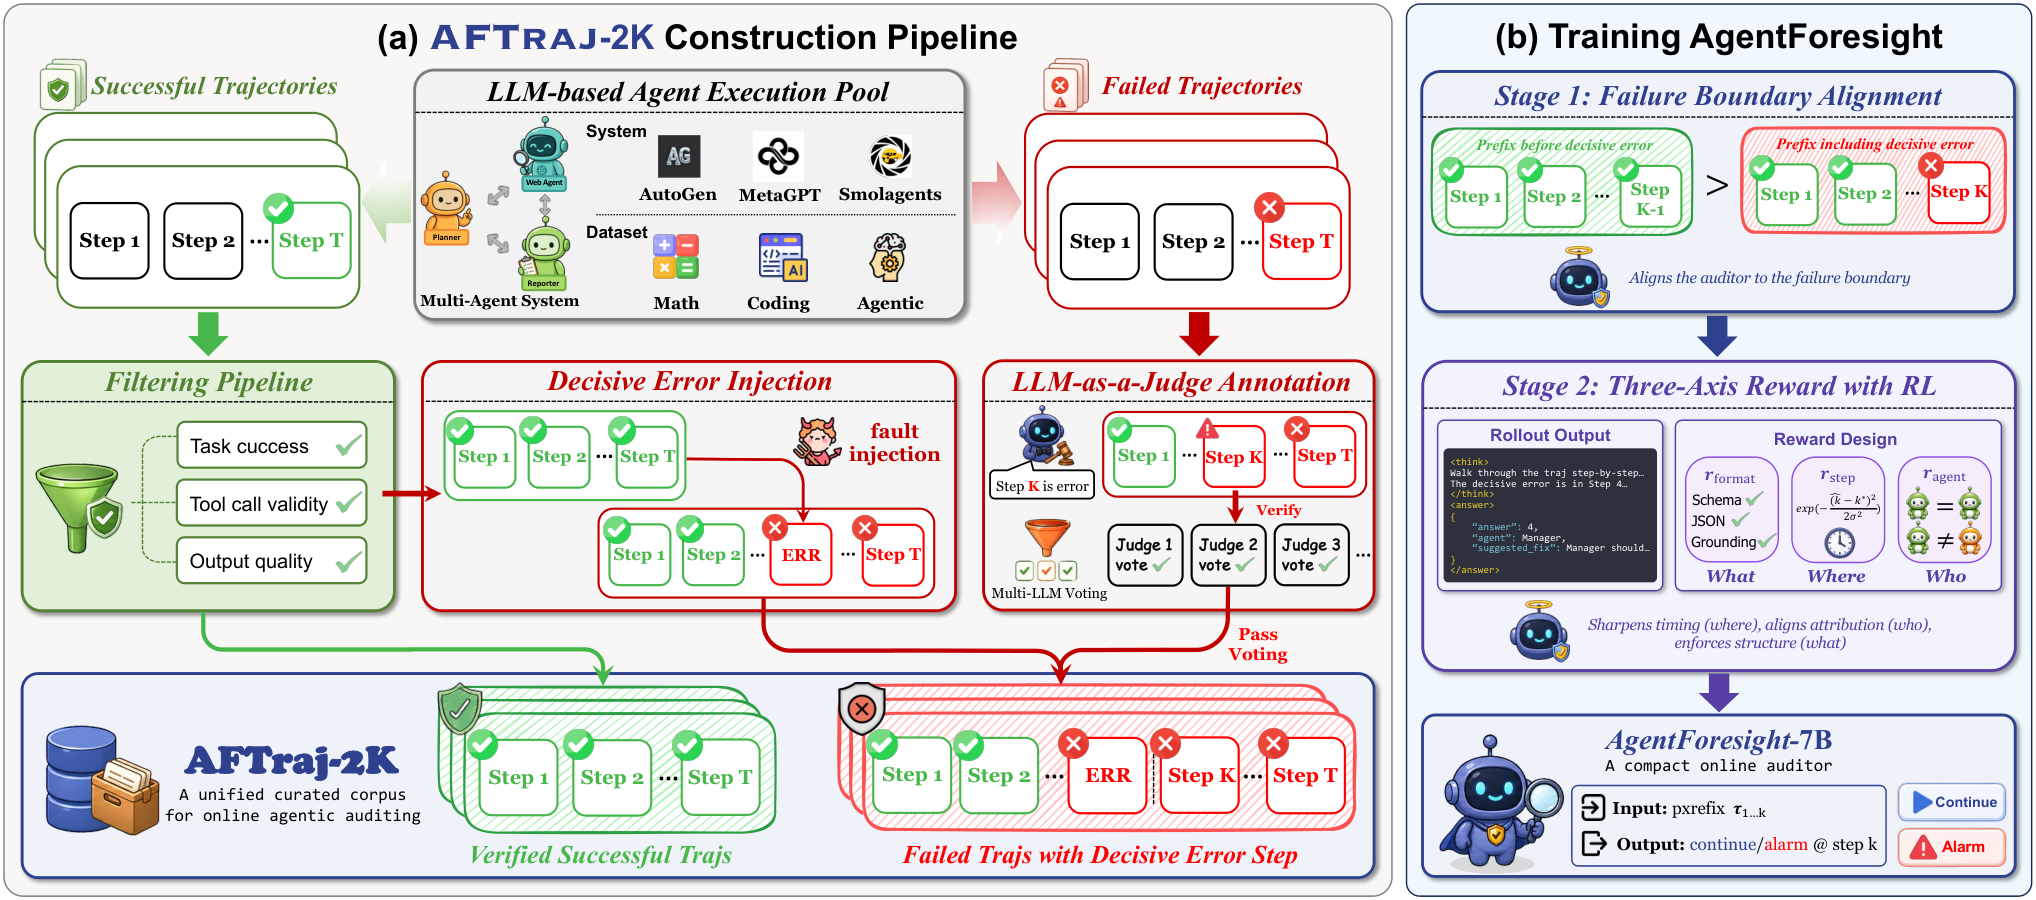
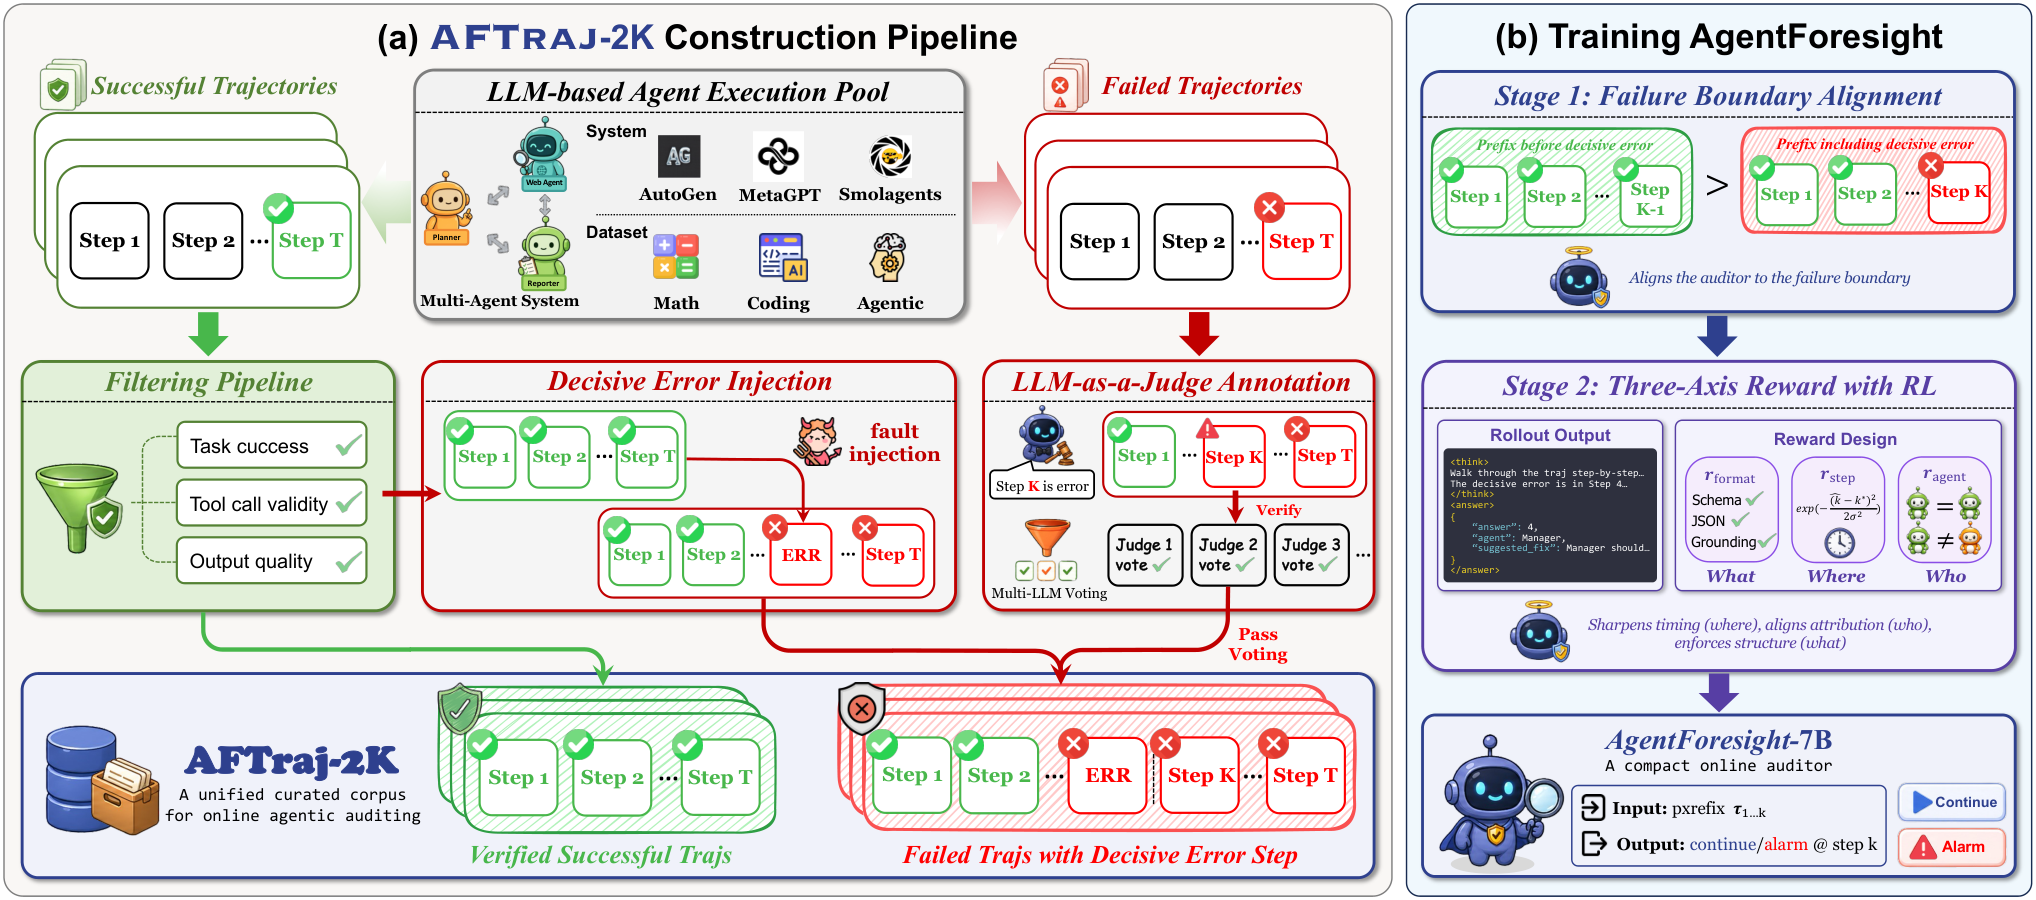
图 2:整体框架。(a) AFTraj-2K 的构造流水线:从现成多智能体系统收集轨迹,成功轨迹经严格过滤得到安全子集,失败轨迹经决定步注入与多裁判投票得到步级标注。(b) 由粗到细的训练配方:先在前缀对上学风险预判,再用三轴奖励锐化为步级定位。
轨迹收集
借鉴现有框架(AutoGen 、MetaGPT、Smolagents)实现多agent系统,在数学(MATH-500)、coding(HumanEval+/MBPP+)、agentic(GAIA/HotpotQA)任务上运行,以 GPT-5.4-mini 作为统一骨干;每条 rollout 按 (\mathrm{role},\mathrm{action},\mathrm{content}) 记录 turn 级轨迹,并用结果函数 Ω 对照参考答案打分。原始池分为
\mathcal{D}_{\text{succ}} 供"验证安全"支路使用;\mathcal{D}_{\text{fail}} 与"对 \mathcal{D}_{\text{succ}} 做受控错误注入"共同产出带决定性错误标注的失败轨迹。
在所有四个子基准上,骨干 LLM 统一为 GPT-5.4-mini,采用贪婪解码,每个任务的步骤预算上限为 40 。
##### 附录 B.3.1 轨迹生成细节###### coding领域使用 AutoGen Swarm,包含两个角色 CodeWriter 和 CodeTester,它们按需移交控制权,并在哨兵
FINAL_VERIFIED_TESTS_PASSED处终止,使用数据集 HumanEval+ 和 MBPP+###### Math领域
- AutoGen Swarm:AutoGen 里的一种调度范式(不是普通自由群聊),核心是控制权移交(hand-off):两个 Agent 轮流接管对话,而不是同时闲聊
- CodeWriter:写代码、写实现
- CodeTester:写测试用例、跑测试、检查 bug,返回报错给 Writer
- 按需移交控制权:Writer 写完交给 Tester 测试;Tester 发现 bug,把控制权还给 Writer 修改;循环往复
- 哨兵(sentinel)
FINAL_VERIFIED_TESTS_PASSED:终止信号Tester 检测到:所有测试全部通过,就输出这个标记,整个多智能体循环直接停下来,不再继续对话。- 评测数据集:
- HumanEval+、MBPP+:经典代码生成评测集,带单元测试,用来测代码能不能跑对
对于 Math,我们使用相同的 AutoGen Swarm 模板,包含 MathSolver 和 Verifier 角色,在哨兵
ANSWER_VERIFIED处终止,运行于 MATH-500 [16]。###### Agentic 领域
- 复用同一个 AutoGen Swarm 模板:调度逻辑不变(轮流移交控制权),只是换角色
- MathSolver:一步步推导数学题、写解题过程
- Verifier:复核推导过程、验算答案,检查有没有计算错误、逻辑漏洞
- 哨兵
ANSWER_VERIFIED:Verifier 确认答案和推导没问题,打出这个标记,流程终止- 数据集:MATH-500,高中难度数学推理 benchmark
对于 Agentic,使用 Smolagents ,其中 CodeAgent Manager 将网络搜索和 Wikipedia 检索委托给 ToolCallingAgent search_agent,运行于 GAIA [33] 和 HotpotQA [57];对于 GAIA,我们还通过将其内容注入智能体提示来处理文件附件(文本格式进行解析,图像进行 base64 编码,音频通过 Whisper 转录):
- 主 Agent:CodeAgent(Manager,总管):Smolagents 的 CodeAgent,习惯写 Python 代码执行动作
- 子 Agent:search_agent(ToolCallingAgent):传统 JSON 工具调用型 Agent,专门封装搜索能力(网页搜索 + Wikipedia 百科检索)
- 委托(delegate): Manager 自己不去直接调用搜索工具,而是把 search_agent 当成一个工具,有需要查资料的时候,调用这个子 Agent 去搜,拿到结果再继续推理。
正好对应刚才讲的 Smolagents 的特点:多 Agent 不是原生群聊,而是子 Agent 包装成工具给主 Agent 调用
- 评测数据集:
- GAIA:真实复杂 Agent 任务 benchmark,经常附带附件(txt、图片、音频),需要阅读附件信息才能回答
- HotpotQA:多跳问答,需要多次检索、综合多处信息
- GAIA 附件处理方案(论文里的工程实现): 任务里附带的文件,全部预处理之后塞进 prompt 给大模型:
- 文本文件:直接解析文字放进 prompt
- 图片:base64 编码,交给多模态模型看
- 音频:先用 Whisper 语音转文字,把转录文本放进 prompt
safe 轨迹处理
根据前面的定义,一条轨迹 τ∈𝒟succ ,只能说明最终结果判定为安全,并非在每一步都符合安全的标准;因为一个静默的中间错误可能被下游智能体的恢复所掩盖,或被宽松的评估标准所掩盖;
将此类轨迹视为正监督会教导审计器对包含警示信号的前缀发出 Continue,这直接削弱了在线审计所要求的前缀受限监督。因此,使用由二元判定 ϕj:𝒯→{0,1} 组成的三阶段过滤流水线,仅保留在每个前缀都安全的轨迹:
- \phi_{\text{outcome}}:与参考答案严格等价;
- \phi_{\text{integrity}}:拒绝任何非法工具调用;
- \phi_{\text{coherence}}:由 LLM 判官检查每个 turn 是否仍与声明子目标一致。
\mathcal{D}_{\text{safe}} 中每条轨迹在每一个前缀上都带标签 (SAFE, ∅),这正是既有语料缺失的正类监督。
###### 附录 B.3.1:三个判定的具体实现
- \phi_{\text{outcome}}:Math 上用 sympy 符号等价 + LaTeX 归一化;GAIA 用官方 scorer 做数字/列表归一化;HotpotQA 用忽略冠词的归一化并容忍人名与地名后缀变体;Coding 用 subprocess 跑测试,超时 15 s。
- \phi_{\text{integrity}}:检查日志,拒绝含工具报错、序列化失败、空预测、因环境受限而终止的轨迹。
- \phi_{\text{coherence}}:用 GPT-5.4 判官逐 turn 检查是否对齐声明子目标。
- 流程实现为"生成后批校验 + 严格跨批次审计"的多轮管线,三轮全部通过才保留。
失败轨迹处理
在线审计需要的训练信号是 (\tau,k^*,a^*),既要有"确实是失败",又要有"决定性步在哪",而这两者都无法从朴素来源里可靠拿到。作者因此设计了覆盖不同失败分布的两条支路:
- 构造支路(constructive stream)——在安全轨迹上注入,标签由构造保证。 沿用 AgenTracer 的范式,对安全轨迹做受控注入:\tilde{\tau}=\tau_{0:k_{\text{inj}}-1}\oplus\tilde{t}_{k_{\text{inj}}}\oplus\tilde{\tau}_{>k_{\text{inj}}},\qquad \tilde{\tau}_{>k_{\text{inj}}}\sim\mathrm{Roll}\bigl(\mathcal{M},\tau_{0:k_{\text{inj}}-1}\oplus\tilde{t}_{k_{\text{inj}}}\bigr)
先均匀采一个注入步 k_{\text{inj}}\in\{1,\ldots,|\tau|-2\}(避开首尾)与故障类别 c\in\mathcal{C};用 \pi_{\text{fault}}(\cdot\mid\tau_{0:k_{\text{inj}}-1},c) 生成一个故障 turn \tilde{t}_{k_{\text{inj}}};从被污染的前缀重新 rollout 出真实后缀 \tilde{\tau}_{>k_{\text{inj}}}。
- 注入后校验:若 \Omega(\tilde{\tau})=1(下游自己恢复了)或目标 turn 实际没被改动,则丢弃;
- 否则通过的样本以构造真值 (k^*,a^*)=(k_{\text{inj}},a_{k_{\text{inj}}}) 进入 \mathcal{D}_{\text{fail}}^{\text{inj}}。
- 对于 Math,{computation_slip, premature_finalization, verification_shortcut, verdict_misread}( |𝒞Math|=4 );
- 对于 Coding,{code_bug, verification_skip, verdict_misread}( |𝒞Coding|=3 )
- 缺少agentic领域;
- 诊断支路(diagnostic stream)——在自然失败轨迹上把未知的决定性步找出来。 采用"提议—验证"的方法,且刻意设计得比单轮多数投票更保守:提议者和验证者均由 GPT-5.4 在温度 0.2 下实例化
P=5 个 proposer 各返回至多 3 个候选(步号 + 责任人 + 失败类型 + 理由 + 修正建议 + 置信度),每个唯一候选再由 V=3 个 verifier 沿四条二元准则 (s_{\text{exists}},s_{\text{substantive}},s_{\text{decisive}},s_{\text{earliest}}) 复查,只有"四准则同时成立的 verifier 数"超过多数阈值的候选才被接受:
k_{\text{cand}}\ \text{admitted}\iff \sum_{j=1}^{V}\prod_{r\in\{s_{\text{exists}},s_{\text{substantive}},s_{\text{decisive}},s_{\text{earliest}}\}} s_{r}^{(j)}\ \ge\ \Bigl\lfloor V/2\Bigr\rfloor+1- \boldsymbol{s_{r}^{(j)}}:第 j 个 verifier 对第 r 条准则的二元判断。
- \boldsymbol{V}:verifier 调用数,实现取 3;阈值因此为 2,即至少两个 verifier 四项全过。
- \boldsymbol{P}:proposer 调用数,实现取 5;。
若出现并列,则依据验证者置信度打破平局。
语料统计
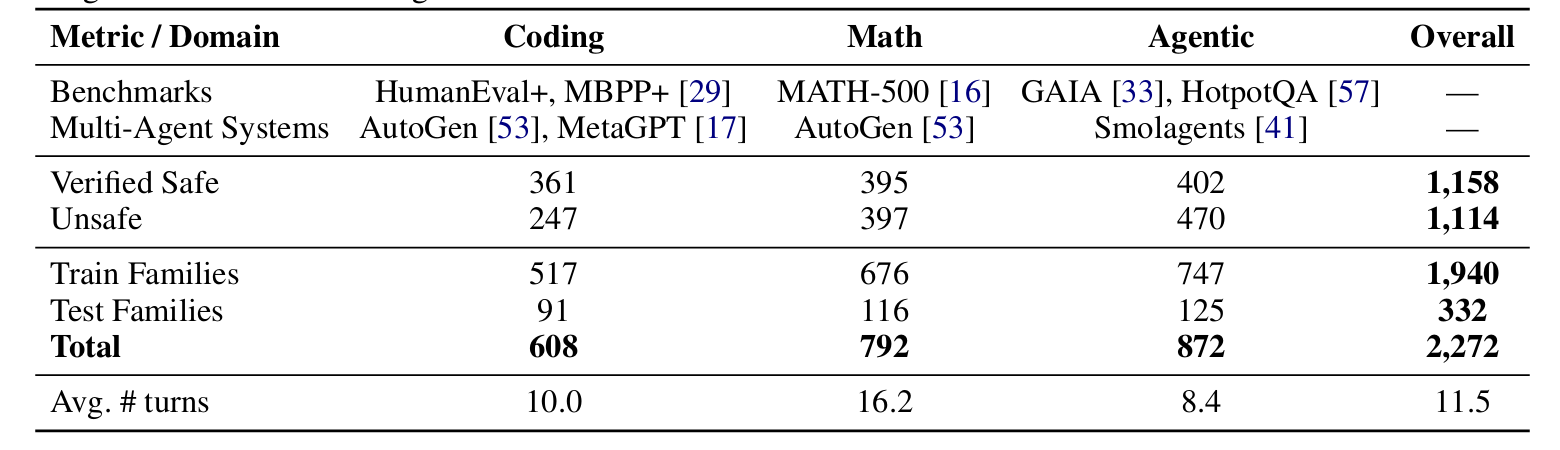
计数在未展开的家族层级报告(每个带标签轨迹一行)。训练和测试家族通过分层划分获得,该划分将每条安全轨迹及其所有变体置于同一分区。Overall 列报告计数的逐行求和以及平均值的加权统计量。
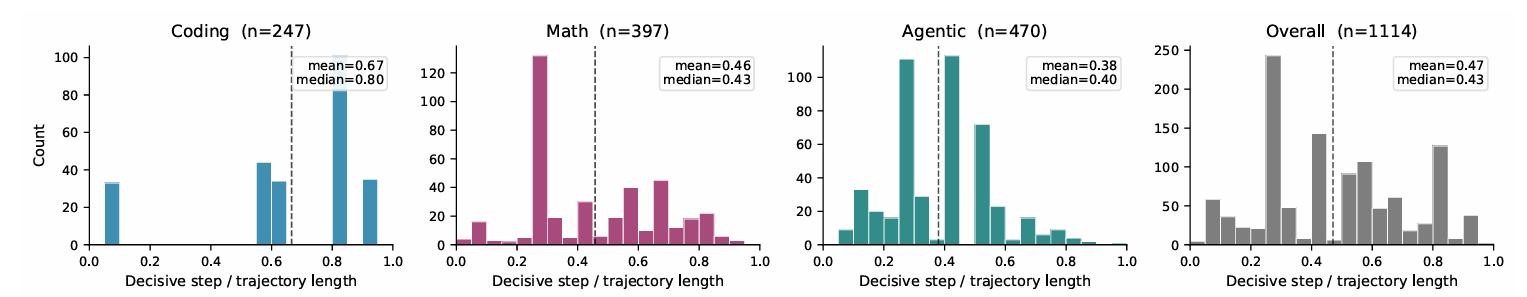
决定性错误步骤(按轨迹长度 N 归一化)在 AFTraj- 2 K 的三个领域及其汇总上的分布。虚线标记每个面板的均值。三个领域呈现出性质上不同的形状:Coding 错误集中在后半段,Math 错误沿轨迹分布并带有长尾,Agentic 错误则集中在前段;而 Overall 面板显示,在全部 1,114 条不安全轨迹中,决定性步骤广泛分布于整条轨迹,而非聚集在某个固定的前缀位置,这支持了如下主张:在线审计器必须经过校准,以便在轨迹实际出错的步骤上作出判定。
coarse-to-fine训练
分阶段的原因
直接用单阶段策略梯度训练,策略会坍缩到对所有前缀都预测 Safe;原因有二:
- 基座模型没有"安全/不安全边界"的内部感知;
- 即使有这个边界,还要在不安全区内定位步与责任 agent,而精确性导向的奖励过于稀疏,无法从零同时建立两种能力。
于是解耦成两段:Stage 1(BPPO)建立失败边界的风险预判先验;Stage 2(GRPO + 三轴奖励)把先验锐化为步级定位。
阶段一:失败边界对齐 BPPO (Boundary-Pair Preference Optimization)
对每条 (\tau,k^*,a^*)\in\mathcal{D}_{\text{unsafe}} 构造两个只差一个 turn 的提示:
- pre-boundary:\tau_{0:k^*-1},最优判决 =
Continue; - post-boundary:\tau_{0:k^*},最优判决 =
Alarm(k^*, a^*)。
两者形式几乎相同,却要求逻辑相反的判决,于是"失败边界"被隔离为最显著的待学信号。作者把这种配对对比转成学习信号,提出 DPO 的变体 BPPO(Boundary-Pair Preference Optimization 边界对偏好优化),两个针对性设计:
- chosen / rejected 响应由基座策略 rollout 后按解析出的判决分类得到(而不是人工写死的正负样本);
- 数据按提示位置分为 \mathcal{D}_{\text{BS}}(边界前)与 \mathcal{D}_{\text{BE}}(边界处)两个子集,联合优化:\mathcal{L}_{\text{BPPO}}(\pi_\theta;\pi_{\text{ref}})=-\!\!\sum_{c\in\{\text{BS},\text{BE}\}}\!\!\mathbb{E}_{(x,v^*,v)\sim\mathcal{D}_c}\Bigl[\log\sigma\bigl(\beta\,\Delta_\theta(x,v^*,v)\bigr)\Bigr]
其中隐含奖励差(implicit-reward margin)为
\Delta_\theta(x,v^*,v)=\log\frac{\pi_\theta(v^*\mid x)}{\pi_{\text{ref}}(v^*\mid x)}-\log\frac{\pi_\theta(v\mid x)}{\pi_{\text{ref}}(v\mid x)}- \boldsymbol{v^{*}}:该位置的最优判决;\mathcal{D}_{\text{BS}} 中 x=\tau_{0:k^{*}-1}、v^{*}=\text{Continue},\mathcal{D}_{\text{BE}} 中 x=\tau_{0:k^{*}}、v^{*}=(\text{Alarm},k^{*},a^{*})。
- \boldsymbol{v}:被拒绝的判决(BS 上非 Continue,BE 上非 v^{*})。
- \boldsymbol{\pi_{\theta}(v\mid x)}:按结构化 JSON 中解析出的 verdict 计算的整段自回归概率。
- \boldsymbol{\beta}:偏好温度,实现取 0.1。
两个子集必须联合优化:只训 BE 会得到"倾向报警"的先验,只训 BS 会得到"倾向通过"的先验,而这对 prompt 共享形式,联合最小化两个子集,才逼出"在 t_{k^{*}} 处翻转判决"这一件事。产物 \pi_{\theta_{1}} 是 Stage 2 的初始化。
阶段二:三轴判决锐化(GRPO)
每次 rollout 产出结构化判定 <think>…</think><answer>{"answer": k|"SAFE", "agent": …, "reason": …}</answer>,沿 what/where/who 三个正交维度打分。
- 结构轴是二值格式门 G(\hat{y})(schema 合法、JSON 可解析、内容有据);
- 时间轴用高斯核给步级定位打分;r_{\text{step}}(\hat{k},k^{*})=\exp\!\Bigl(-\frac{(\hat{k}-k^{*})^{2}}{2\sigma_{\text{step}}^{2}}\Bigr)
- 因果轴给责任人打分(角色完全匹配满分,不匹配给部分分):
- \boldsymbol{\sigma_{\text{step}}}:步距容忍尺度,控制"错一步"扣多少分(原文未给具体取值)。
- \boldsymbol{G(\hat{y})}:格式门,0/1;为 0 时整条内容分作废。
- \boldsymbol{R_{\text{content}}}:Safe 判对得 +1;Alarm 判对得 w_{s}r_{\text{step}}+w_{a}r_{\text{agent}}(w_{s}+w_{a}=1);跨类错误得 -1。
- \boldsymbol{\eta_{G}}:格式违规的软惩罚系数,训练早期保留梯度用。
类对称的 \pm1 设计是为了防类别偏置漂移(否则模型会靠"全报警"或"全放行"刷分)
- (1-G) 的软惩罚则是为了在策略还没学会 schema 时不至于零梯度。外层用 GRPO 优化,两处针对本设定的改造:KL 的参考策略锚在 Stage 1 检查点 \pi_{\theta_{1}} 而不是基座;KL 用 k3 估计量(非负、长轨迹上梯度噪声更低)。
- \boldsymbol{\rho_{j,t}(\theta)}:token 级重要性比 \pi_{\theta}/\pi_{\text{old}}。
- \boldsymbol{A_{j}}:组内标准化后的优势(G=8 条 rollout 的 R 减去组均值除以标准差),无需 critic。
- \boldsymbol{\hat{D}_{\text{KL}}}:k3 估计的 KL,实现为 verl 的
low_var_kl。 - \boldsymbol{\beta_{\text{KL}}}:KL 系数,实现取 10^{-3}。
实验
验证覆盖两类设置:自建分布内(AFTraj-2K 的 15% 分组留出集)与跨构造外部迁移(Who&When),同时报告效果(Exact-F1、Step-Acc、Agent-Acc)与部署属性(ASS 步距误差、FAR 误报率、单次调用延迟与单价)。
实验设置
- 数据。
AFTraj-2K 按 family 分组留出 15%(测试 332 条 family,即 91 Coding / 116 Math / 125 Agentic),安全轨迹与其注入变体同侧。采用按轨迹分组的划分方式留出 AFTraj- 2 K 的 15% ,将每条安全轨迹及其注入的不安全变体置于同一分区,以防止训练-测试泄漏
Who&When 含 127 个多智能体系统的人工标注 (\text{agent},\text{step}) 对,全部轨迹与 AFTraj-2K 在系统构造与底层任务上都无交集;该基准只发布已确认失败的轨迹,因此只能评定位、不能评误报。
- 基线。
- 开源小模型:Llama-3.2-3B、Gemma-3-4B、Qwen2.5-7B-Instruct、Qwen3-8B、Qwen3-32B。
- 闭源:GPT-4.1、Gemini-3-Flash、Claude-Haiku-4.5、DeepSeek-V4-Flash、DeepSeek-V4-Pro。
- 方法论基线:在同一 Qwen2.5-7B-Instruct 上实例化的四种范式
- Perplexity-7B,按回合长度归一化对数似然 + 首次穿越阈值;
- 树搜索式提示(ToT-7B,\{\text{Sure},\text{Likely},\text{Impossible}\}\to\{2,1,0\} + 首次穿越);
- 自我反思(Reflexion-7B,读"这一步是否含关键错误"的 yes/no 下一 token 分布)p_{\text{ok},k}=\frac{P(\text{no})}{P(\text{yes})+P(\text{no})},跌破阈值时alarm;
- 事后归因(AgentDebug-7B,唯一看完整轨迹的基线,作为事后范式的参照)。
除 AgentDebug-7B 外都走同一套在线协议、贪心解码、单次响应预算 1,500 token。
- 指标。
- Exact-Step F1(Exact-F1)是步级精确命中在 recall(分母为全部失败轨迹)与 precision(分母为被报警的失败轨迹)上的调和平均,同时罚漏报与错定位;
- Step Recall 是决定性步骤被精确定位的不安全轨迹所占比例
\text{Recall}_{step}=\frac{|\{\tau\in U:\ \hat{k}(\tau)=k^*(\tau)\}|}{|U|}
- Step Precision 含义相同,只不过分母不再是所有全部失败轨迹,而是模型报警轨迹
\text{Precision}_{step}=\frac{|\{\tau\in U_{\text{det}}:\ \hat{k}(\tau)=k^*(\tau)\}|}{|U_{\text{det}}|}
- Step Recall 是决定性步骤被精确定位的不安全轨迹所占比例
- Absolute Step Shift(ASS)是被检出失败轨迹上 |\hat{k}-k^{*}| 的均值。即使告警未能命中确切步骤,ASS 仍具有信息量,它提供了定位质量的分级信号,这是 Exact-F1 中的二元正确性无法捕捉的;遗漏检测的轨迹上未定义;
\text{ASS}=\frac{1}{|U_{\text{det}}|}\sum_{\tau\in U_{\text{det}}}\left|\hat{k}(\tau)-k^*(\tau)\right|
评测走严格逐步增量:每个 prefix \tau_{0:k} 贪心查询一次,安全与失败轨迹都走满全长以暴露误报。
- Exact-Step F1(Exact-F1)是步级精确命中在 recall(分母为全部失败轨迹)与 precision(分母为被报警的失败轨迹)上的调和平均,同时罚漏报与错定位;
| 超参 | Stage 1 | Stage 2 |
|---|---|---|
| 基座 / 冻结参考 | Qwen2.5-7B-Instruct / \pi_{\theta_{0}} | \pi_{\theta_{1}} / \pi_{\theta_{1}} |
| 训练样本 | 1,902 对边界 prompt | 1,940 prompt × G |
| 学习率 / 调度 | 5\times10^{-7},cosine + 50 步 warmup | 1\times10^{-6},constant |
| 优化器 / 精度 | 8-bit AdamW(bitsandbytes)/ bf16 | AdamW / bf16 |
| \beta 或 \beta_{\text{KL}} | \beta=0.1 | \beta_{\text{KL}}=10^{-3}(k3) |
| 有效 batch / 组大小 | 16(1\times16 梯度累积) | 32 / G=8 |
| 轮数 | 3 | 8 |
| 最大长度 | prompt 8,192 | prompt 8,192 / response 4,096 |
| 硬件 | 2\timesH200 | 2\timesH200 |
主要结果
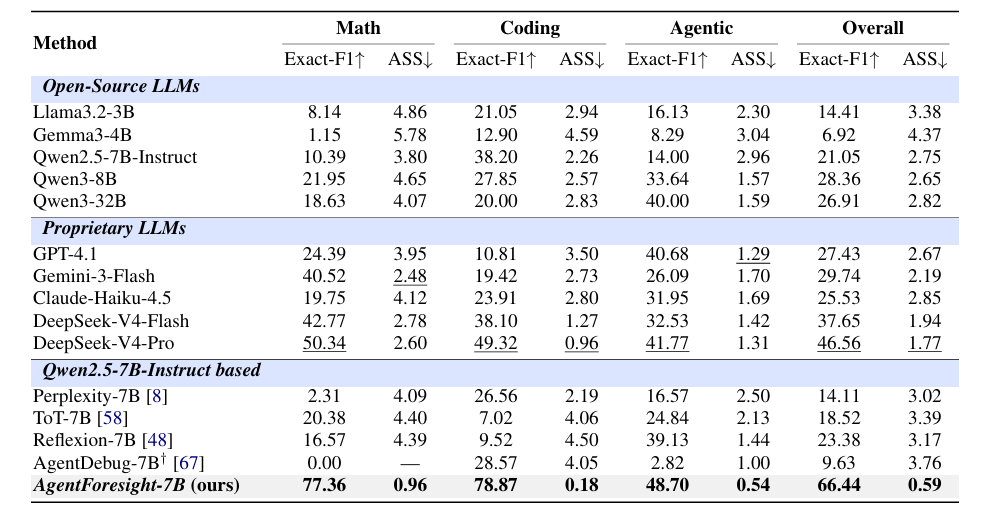
- 在 AFTraj- 2 K 上的在线审计评估。粗体 = 表示最佳结果,下划线 = 表示次佳结果。
- † AgentDebug-7B 未检测到任何不安全轨迹,没有可用于求平均的步移样本。我们使用“—”将其 ASS 标记为未定义。
总体而言,AgentForesight-7B 达到 66.44 Exact-F1,比最强的专有基线 DeepSeek-V4-Pro 高出 19.88 个百分点,并将总体 ASS 从 1.77 收紧至 0.59 ( 3× )。
按领域来看,AgentForesight-7B 在每个领域的 Exact-F1 和 ASS 上均表现更好,其中 Exact-F1 提升最大的是数学( 77.36 对 50.34 )和编程( 78.87 对 49.32 )。
第 3.2 节的由粗到细方案将 Qwen2.5-7B-Instruct 主干在 Exact-F1 上提升了 3.16× ,而 AgentDebug-7B——具备完整轨迹事后视角的事后参考方法——总体 Exact-F1 最低,为 9.63 。这些结果表明,AgentForesight 的增益源于其为在线审计量身定制的由粗到细方案,而非来自扩展主干模型或改造现有的事后归因器。
对此外部基准的泛化能力。
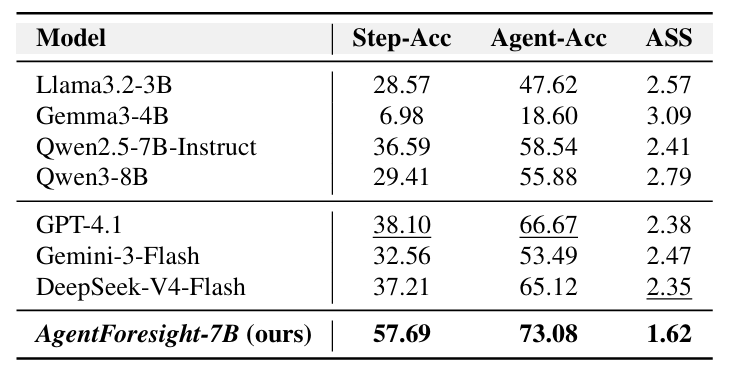
AgentForesight-7B 迁移到外部 Who&When 基准,它在全部三项指标上均领先,在 Step-Acc 上超过最强基线 GPT-4.1 达 19.59 分,在 Agent-Acc 上超过 6.41 分,并将 ASS 从 2.35 (DeepSeek-V4-Flash)降至 1.62 。由于这些轨迹在训练时完全未见,这一迁移表明 AgentForesight-7B 捕获的在线审计信号能够泛化到 AFTraj- 2 K 的框架选择之外,而非对其整理产物过拟合。
消融实验
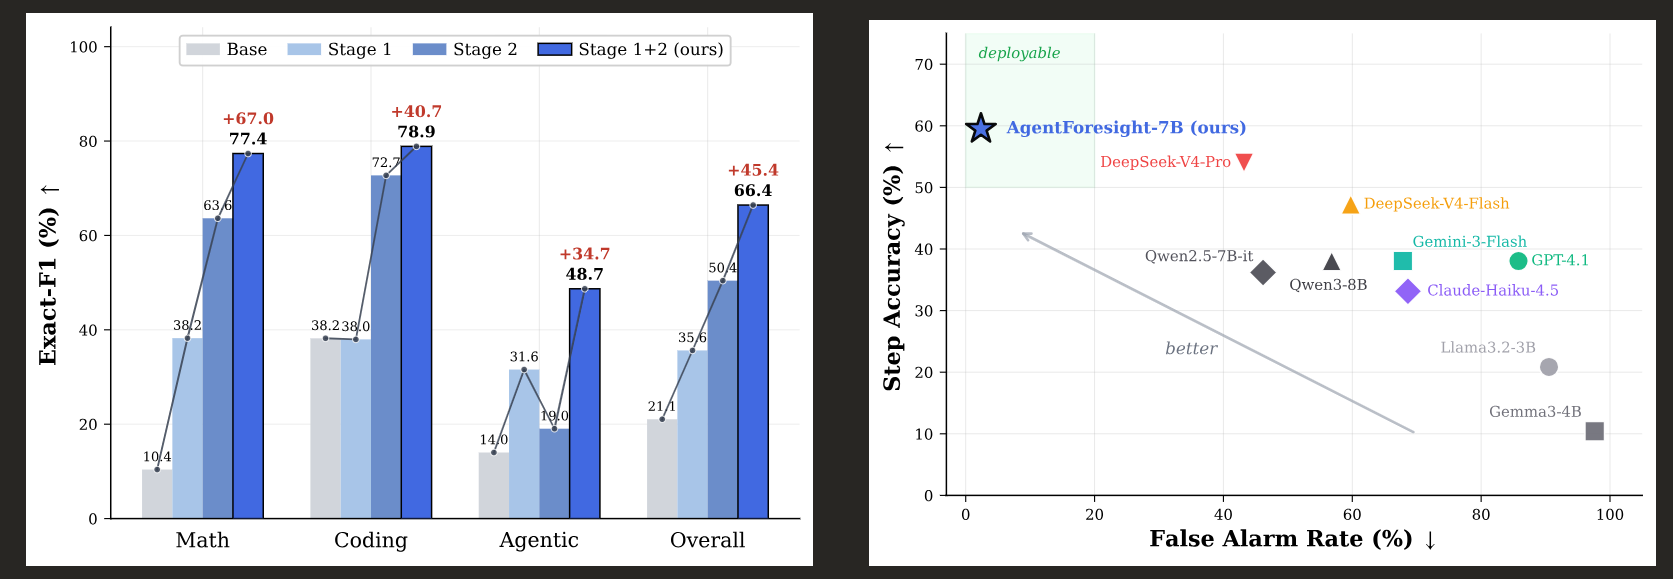
在 Qwen2.5-7B-Instruct 基座上对我们的由粗到细方案的两个阶段进行了消融。每个阶段单独都能提升 Exact-F1,从基座的 21.1 (阶段 1 提升至 35.6 ,阶段 2 提升至 50.4 ),而将两者结合后,AgentForesight-7B 达到 66.4 ,至少比任一单阶段高出 16 分。
分项结果揭示了明确的分工:仅阶段 2 就已能处理 Math( 63.6 )和 Coding( 72.7 )——在这些领域,决定性错误可以被清晰定位——但在 Agentic( 19.0 ,低于仅阶段 1 的 31.6 )上出现退化,因为该领域的失败边界更难区分。在完整方案中借助阶段 1 的风险预判先验,Agentic 领域恢复至 48.70 。
这验证了“先预测、后定位”的耦合机制:阶段 1 建立了一个可学习的失败边界,阶段 2 将其细化到步骤级精度。
可部署的在线审计器必须准确放置警报,同时极少打断安全轨迹。图 4 描绘了这一权衡关系,将 Step Accuracy( 𝒟unsafe 上的)与 False Alarm Rate(FAR, 𝒟safe 上,即出现任何已触发警报的安全轨迹占比)进行对照绘制。
我们进一步在 FAR ≤20% 和 Step-Acc ≥50% 处标记出一个可部署区域,即下游分诊或恢复路由仍可处理的工作点。在所比较的十个审计器中,只有 AgentForesight-7B(FAR =2.4% ,Step-Acc =59.5% )位于该区域内。在两个轴上均为最强的专有基线 DeepSeek-V4-Pro(FAR =43.2% ,Step-Acc =54.0% )恰好落在区域之外,而其他专有评判器和开源 7–8B 基础模型集中于高 FAR 与中等 Step-Acc,3–4B LLMs 则退化为近乎普遍的误报。
这一差距与我们的由粗到细方案一致:Stage 1 的风险预判先验抑制了虚假警报,Stage 2 的三轴奖励则锐化了警报放置。
案例分析
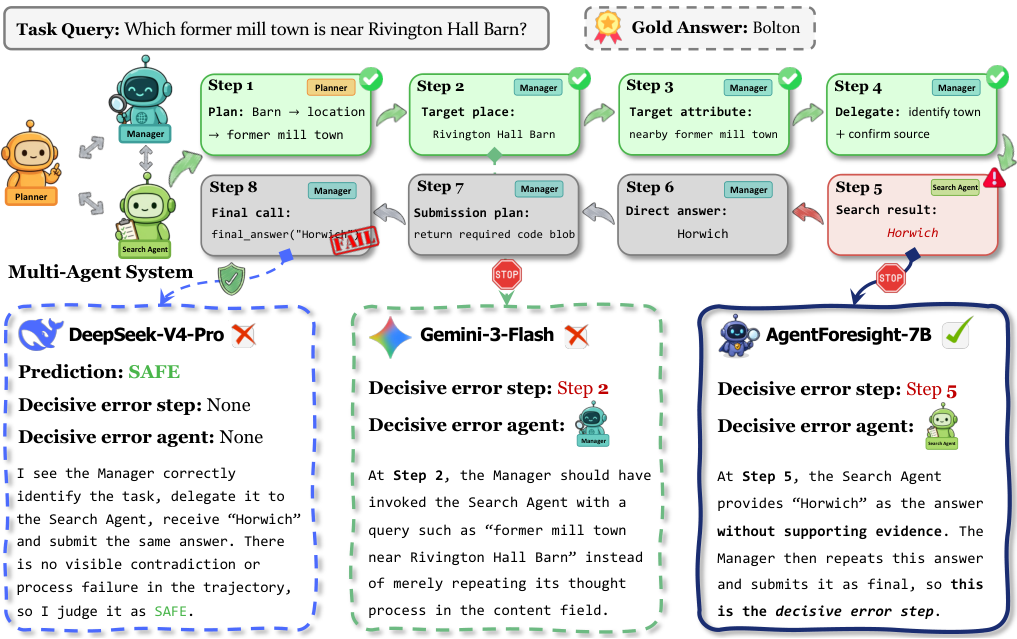
展示了一条智能体轨迹,其决定性错误发生在第 3 步:search_agent 返回了错误城镇 Horwich,而非标准答案 Bolton,Manager 将其传播至任务完成。仅 AgentForesight-7B 返回第 5 步,并将 search_agent 标记为责任智能体。两个强专有基线以相反方向失败。Gemini-3-Flash 标记了 Manager 规划思考的第 2 步,而 DeepSeek-V4-Pro 在监控整条轨迹后返回 Safe。这表明有效的在线审计既要求避免对安全前缀过早报警,又要求检测出强基线完全遗漏的决定性错误。
结论
在本文中,我们提出 AgentForesight,一种面向智能体失败分析的在线审计视角,将其从对已完成轨迹的事后诊断,重构为对每个展开前缀逐步作出继续或告警的决策。基于这一视角,我们引入 AFTraj- 2 K,这是一个经过精心构建的语料库,在 Coding、Math 和 Agentic 领域中,将经过严格筛选的安全运行与经多评判器验证的决定性错误标注配对。我们开发了 AgentForesight-7B,这是一个紧凑的在线审计器,通过由粗到细的强化学习方案训练:首先在相邻的安全/不安全前缀对上,使其在失败边界处获得风险预判先验,然后在三轴奖励下将该先验锐化为精确的步骤级定位,该奖励联合针对审计裁决的 what、where 和 who。在 AFTraj- 2 K 和外部 Who&When 基准上的大量实验验证了 AgentForesight-7B 的有效性。除了推进在线审计之外,我们的框架还为运行时防护机制铺平了道路,使其能够在下游传播将失败锁定之前进行干预,标志着迈向多智能体系统部署就绪监督的一步。
限制
- 没有漏检相关的指标;
- agentic领域仍然有所欠缺;