Mistake Notebook Learning: Batch-Clustered Failures for Training-Free Agent Adaptation
题目:Mistake Notebook Learning: Batch-Clustered Failures for Training-Free Agent Adaptation 作者:Xuanbo Su, Yingfang Zhang, Hao Luo, Xiaoteng Liu, Leo Huang(佰融、哈工大、吉林大学)arXiv 发表信息:ACL Findings 2026;arXiv:2512.11485v2(2026.1.15) 代码仓库:https://github.com/Bairong-Xdynamics/MistakeNotebookLearning
研究背景
Agent系统的关键局限是它们无法系统地从这些错误中学习,迫使它们在相似情境中重复相同的错误。
- 参数调优:通常依赖计算密集型流水线,涉及监督微调(SFT)、强化学习(RL)或演化优化,以将能力内化到模型权重中。计算成本高、对分布偏移脆弱以及在动态环境中测试时僵化等问题,阻碍了持续学习所必需的快速迭代。
AgentTuning、FireAct、AgentEvolver、A survey on large language model based autonomous agents.
- Training-free的上下文调优:以实例为单位存储经验,以在局部纠正错误。然而,它们往往缺乏主题级抽象,导致行为脆弱且泛化能力有限。此外,现有方法从失败中提取原则或规则,但是往往将错误视为孤立实例,或依赖静态规则提取。
记忆管理方向
- 非结构化文本日志:Generative agents: interactive simulacra of human behavior.:将 Agent 的经历以自然语言形式存入记忆流(Memory Stream),通过相关性、时效性和重要性进行检索,并利用 Reflection 将原始经历总结为更高层次的认知。
- 强化学习优化记忆管理策略:
- Memory-r1:使用强化学习训练独立的记忆管理器执行 ADD、UPDATE、DELETE、NOOP 等操作,同时训练答案生成侧利用记忆,让记忆管理从固定规则转向基于任务反馈的策略学习。
- Mem-α;根据完整交互历史上的下游问答效果构造奖励,训练 Agent 学习如何提取、组织和更新记忆,并设计核心、情景和语义等不同记忆组件。
经验获取方向
- Reflexion:在任务执行失败或获得反馈后,Agent 通过语言反思总结失败原因,并把反思存入情景记忆,供后续尝试参考,实现不更新模型参数的语言式强化学习。
- Self-Refine:让同一个 LLM 反复执行初始生成、反馈评价和结果修订,以测试时的迭代改进提升当前输出质量,无需额外训练。
- LEAP:主动诱导模型在少量示例上犯错,再从错误中归纳任务相关的通用原则,并将这些原则用于解决未见过的问题。
- ExpeL:从成功与失败的任务经历中归纳可复用的经验和规则,并将其用于后续任务决策,使 Agent 能够从历史轨迹中积累知识,而不必只依赖人工编写的提示词。
- In-Context Principle Learning
- ACE:将上下文视为持续演化的 Playbook,通过生成、反思和整理三个模块增量积累策略,减少反复压缩提示词导致的信息丢失。
- ReasoningBank:从 Agent 自我判断的成功与失败轨迹中提炼可迁移的推理策略,形成可检索、可持续更新的推理记忆,并通过测试时扩展机制进一步丰富经验。
经验优化方向
- Training-Free GRPO:借鉴 GRPO 的组内相对比较思想,通过比较多条候选轨迹的表现、提炼高质量经验并将其作为推理时的 Token Prior 引入模型调用,在不更新模型参数的情况下优化 Agent 的行为。
- Memento:将持续学习建模为基于记忆的在线强化学习,通过案例推理(Case-Based Reasoning,CBR)检索和复用历史经验,并通过记忆读写更新行为策略,而不必修改底层 LLM 参数。
错误检测方向
- Who&When:构建包含 127 个多 Agent 系统失败日志的数据集,并研究如何从完整执行轨迹中识别责任 Agent 和决定任务成败的关键错误步骤,建立多 Agent 失败归因的评测基准。
- AgentDebug:建立覆盖记忆、反思、规划、动作和系统操作的错误分类体系,构建标注失败轨迹的数据集,并通过定位根因和生成纠正反馈帮助 Agent 恢复与迭代改进。
- agentguard:在 Agent 外部设置运行时监控层,将输入输出抽象为形式化事件,在线构建和更新马尔可夫决策过程(MDP),再利用概率模型检测验证运行行为是否满足指定属性。
- AgentForesight:训练 AgentForesight-7B 审计模型,仅根据当前执行轨迹前缀判断是否出现决定性错误,并定位错误内容、位置和责任方,使错误检测从事后分析转向执行过程中的在线预警
方法
MNL主要流程
该框架遵循闭环流程,迭代执行基线生成、记忆更新和更新后评估,使智能体能够在不同任务领域和学习范式中自我演化。
Mistake Notebook Learning(MNL)这是一种无需训练的 memory 框架:Tuner Model 通过提示式主题聚类,在批次内按主题对失败进行聚类,并提炼出泛化的错误模式和纠正策略,从而形成稳定且可迁移的记忆。,并且仅在批次性能提升时才提交更新。
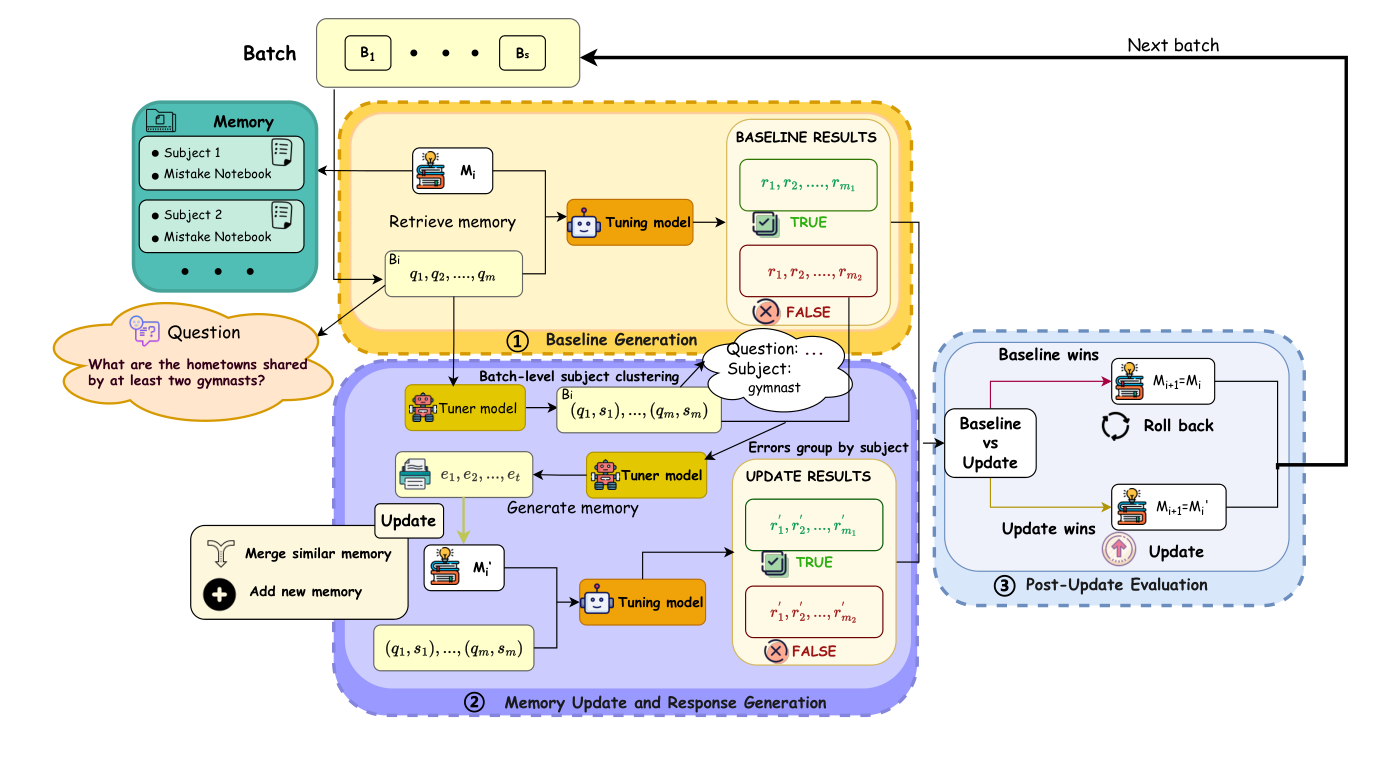
- 基线生成—— Tuning Model 使用当前提示和记忆生成初始响应,以建立性能基线。
- 记忆更新与响应生成——Tuner Model 通过提示执行批次级主题聚类,分析基线错误,创建结构化指导项,并选择性地更新记忆。随后,agent生成更新后的响应。
- 更新后评估——比较更新前后的性能,以评估修订后记忆的有效性,并决定是否接受该更新。
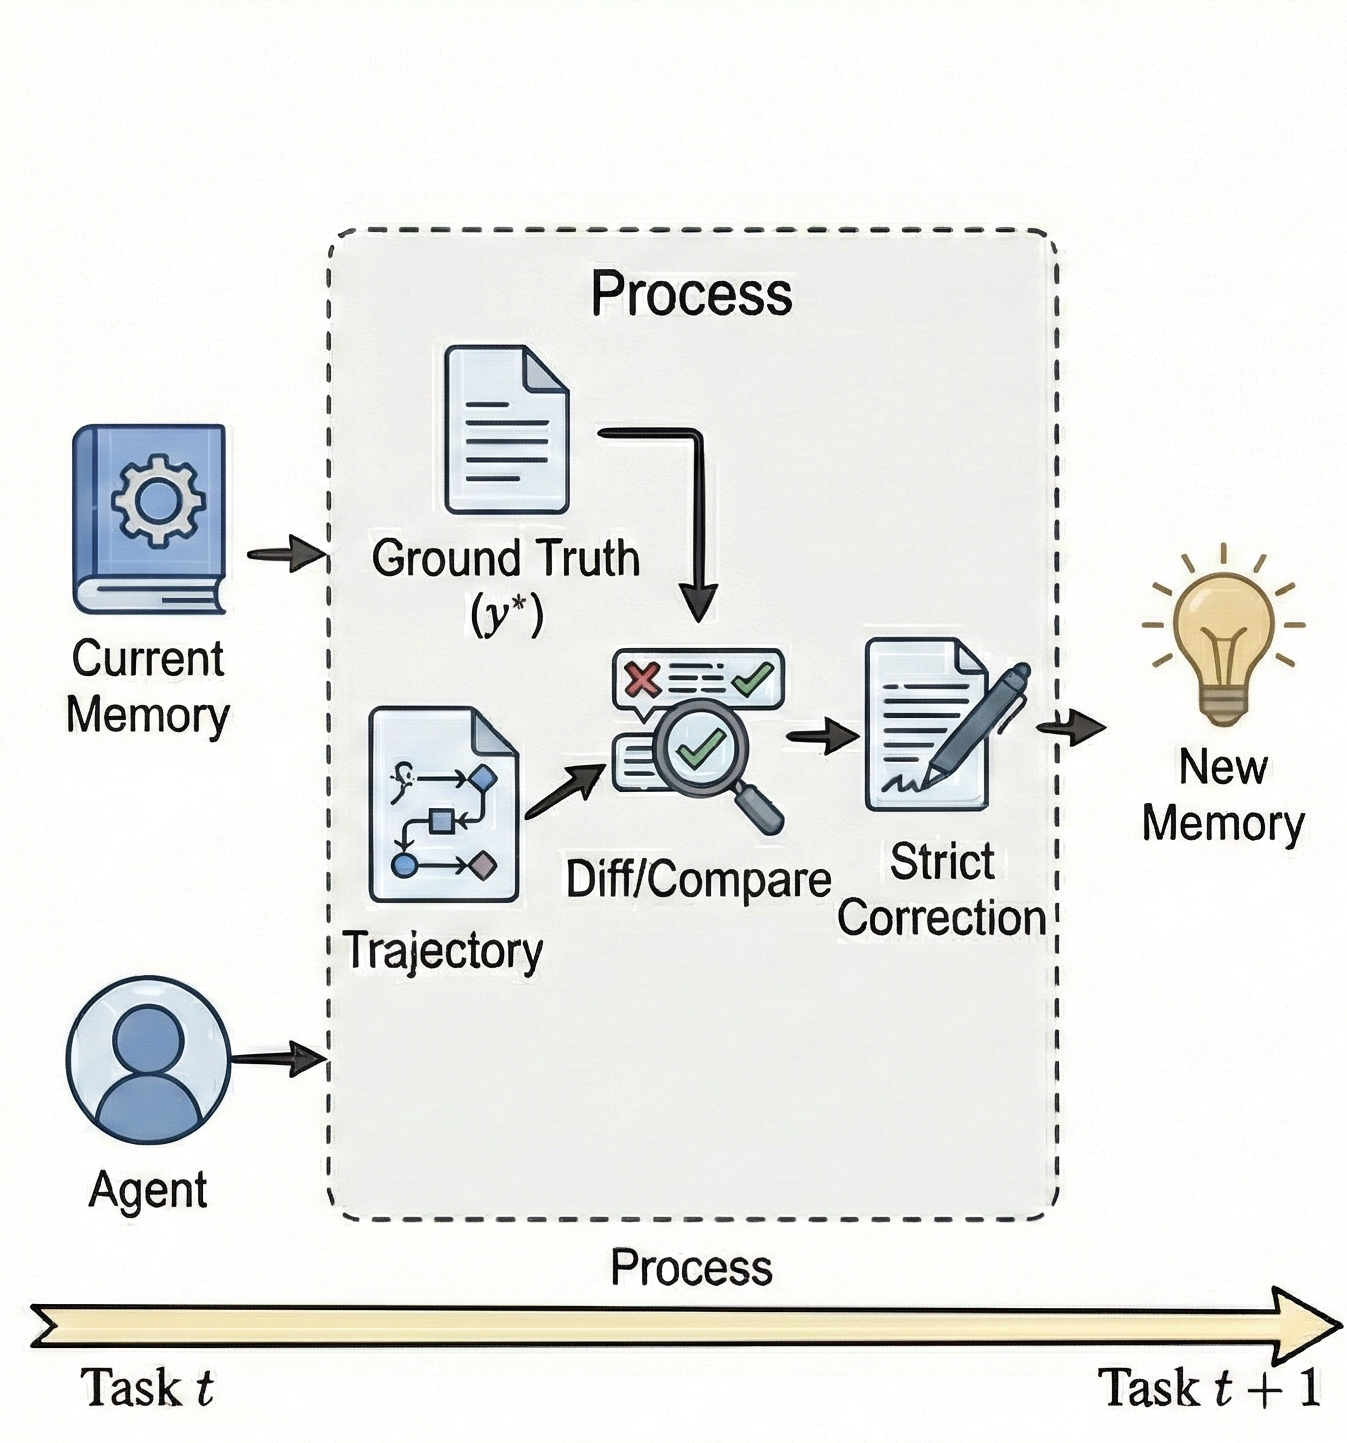 监督进化依赖显式真实标签进行直接的轨迹修正
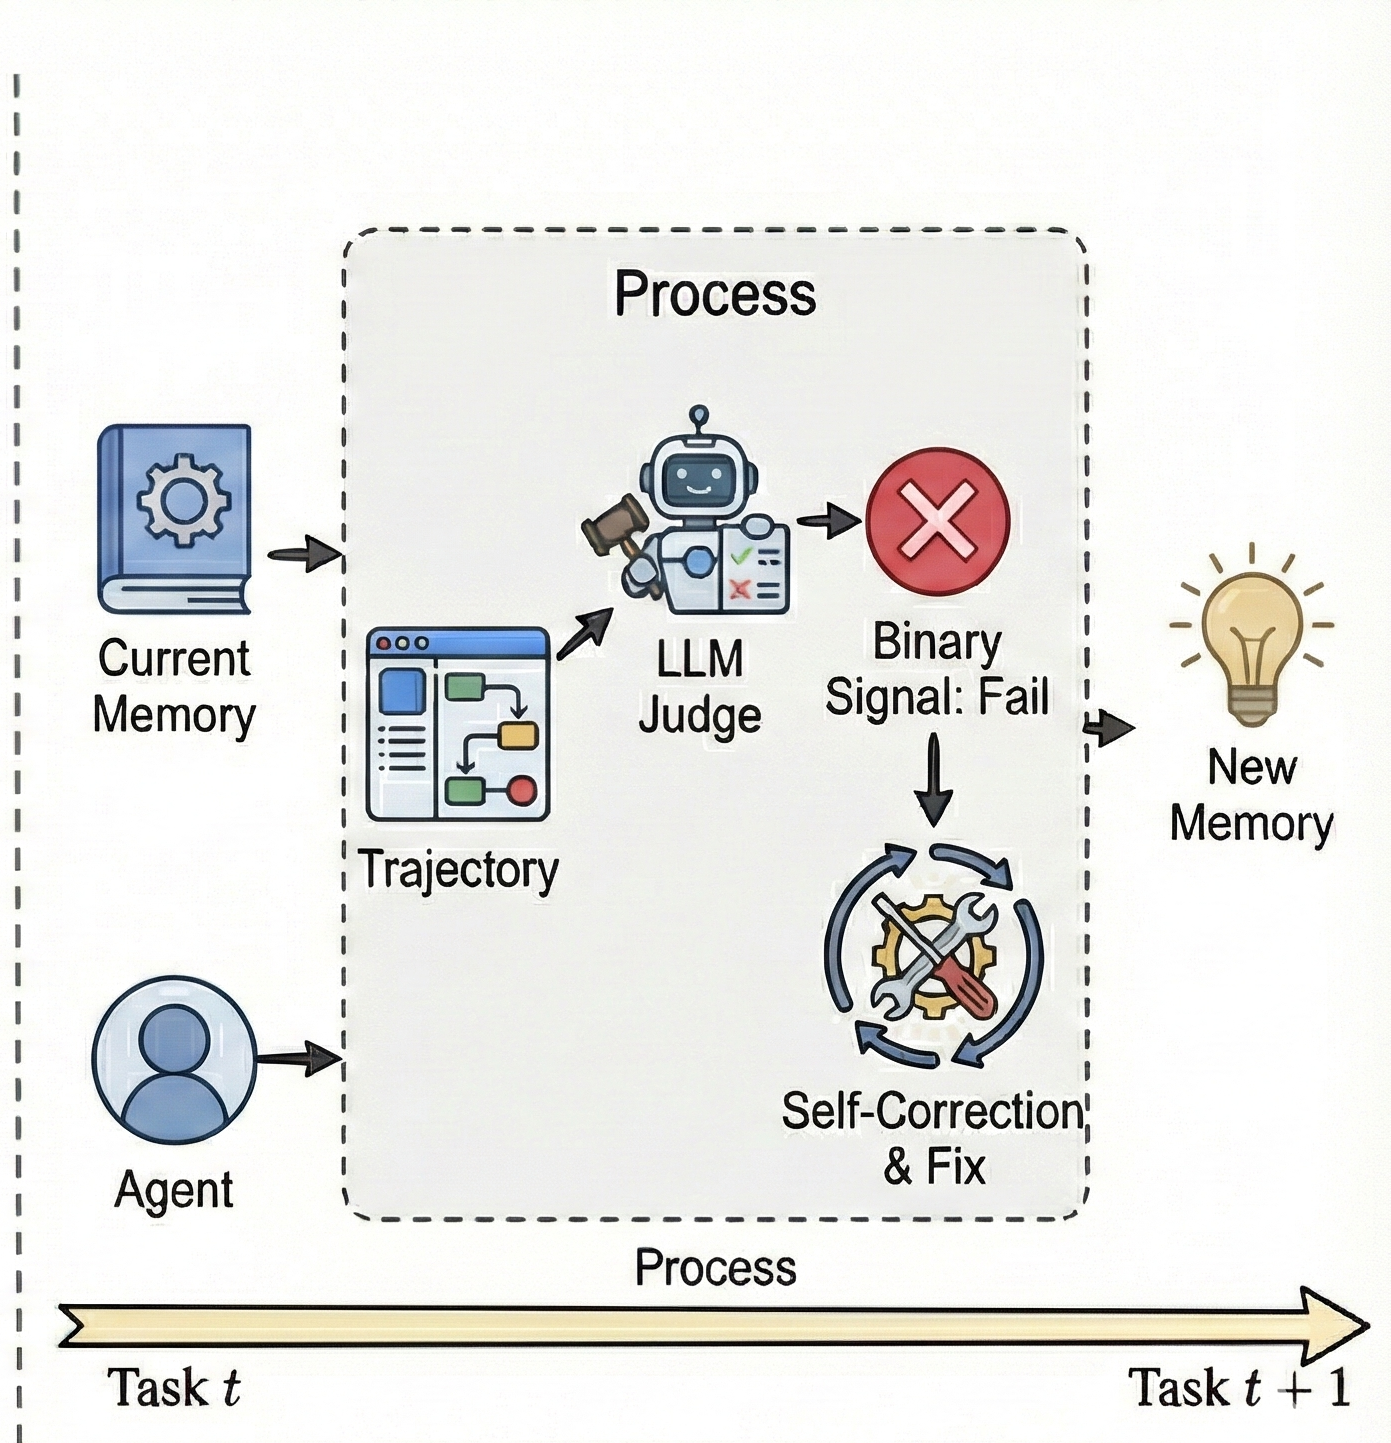 自进化利用外部验证器生成二元信号
在有监督演化范式中,其中使用显式的真实答案来确定输出正确性并为记忆构建提供反馈。
对于智能体任务,MNL 运行在自进化范式中,其中以基于 LLM 的评判器实现的代理验证器评估轨迹结果并产生二元效用信号,这使得无需访问真实标签即可生成记忆。
问题建模
将 MNL 形式化为一个上下文优化问题,旨在构建一个语义记忆 ℳ ,以最大化冻结策略 πθ 的期望奖励。MNL 不更新模型参数,而是通过精炼记忆 ℳ 来提升性能,以确保检索到的上下文 Ret(x,ℳ) 为每个输入 x 提供有效指导。
形式上,对于任务分布 𝒟={(x,y)},我们寻求一个最优记忆
其中 ⊕ 表示提示拼接, R(⋅) 是奖励函数。在有监督设置中, R 由真实标签导出;在自我纠正设置中,它由代理验证器估计。
ℳ 的优化使用一个专用的调优器模型( π_{tuner} )。与调优模型 πθ 的推理角色不同,调优器模型充当反思性监督者。它聚合来自 πθ 的失败轨迹,执行提示驱动的主题聚类以识别跨批次的系统性错误模式,并合成结构化修正以更新记忆。这种执行( πθ )与演化( πtuner )的解耦使 MNL 能够支持多种部署配置,例如自我纠正 Madaan et al. (2023) 或专家引导蒸馏 Kim et al. (2025)。控制调优器模型操作的详细提示见附录 A.3。
记忆模式与存储
为确保可扩展性和高效检索,我们以 JSONL 格式维护记忆 ℳ,其中每个条目定义为结构化元组 e=⟨s,g,ϕ(s)⟩;
- Subject( s )主题,用作高层语义聚类标识符(例如“SQL:空值上的连接条件”),以便于进行广泛的主题匹配。
- Memory( g )包含五个必需组件,以确保可操作性和安全性:
- Corrected Examples,提供明确的错误-答案对,为抽象提供依据;
- Correct Approach,详述逐步推理方法;
- Mistake Summary,识别错误的根本原因;
- Generalizable Strategy,总结可复用的解决模式;
- Anti-Patterns,即关键警告,指明误用场景以防止过度泛化。
- Embedding( ϕ(s) )表示 subject 的语义向量,已预先计算,以便针对传入的查询嵌入实现高效的跨模态检索。
MNL进化详细过程
- 基线生成:
该过程始于调优模型 π_θ 为一批查询生成初始响应。对于每个查询 x ,系统检索相关记忆条目 Ret(x,ℳ) 作为建议上下文。
调优模型被指示批判性地评估该上下文,而不是盲目遵循它,从而降低幻觉风险。
为降低 tuning 模型 πθ 盲目遵循可能无关的历史建议的风险,附加了一条特定的适用性评估指令。这迫使模型在生成初始基线响应之前,批判性地评估所检索条目的相关性。
The following mistake notes are not necessarily tied to the current question, but you may use them to deepen your analytical approach. IMPORTANT: Before applying any guidance below, carefully evaluate: 1.Does the current problem match the applicability conditions stated in the guidance? 2.Is the problem type and context similar to the examples in the guidance? 3.If the problem is fundamentally different (e.g., combinatorics vs modulo arithmetic, complex numbers vs number theory), do NOT force-fit the guidance. 4.Only use guidance that is clearly relevant to the current problem structure and requirements. Before solving, review the attached guidance. State whether it is: “applicable”, “partially applicable”, or “irrelevant”. Use only applicable parts when answering. - 记忆更新与响应生成:
- 评价
基线回答生成以后,采用过滤机制来识别高价值的学习机会。
对于具有确定性答案的领域(例如 Text-to-SQL、Math),正确性通过真实值比较来确定;对于开放式智能体任务,我们使用 LLM-as-a-judge 来分析轨迹并生成二元的成功/失败信号。更新过程在主题级别而非实例级别运行。我们首先采用主题聚类步骤,将失败的查询分组为语义簇。
Mind2Web 评估提示词
两种评判机制,当智能体生成多个候选动作时,judge 同时分析两个选项,以基于 UI 逻辑确定最优的下一步。否则 judge 充当二元验证器,单独分析特定动作,以确定其在交互流程中的有效性。
Pairwise Comparison Judge Prompt
You are an expert in web navigation and user interface interaction.
Given this web navigation task: {question}
Compare these two proposed actions and determine which one is MORE CORRECT:
Action A: {answer1} Action B: {answer2}
Evaluation criteria (in order of importance):
Task relevance - Does this action directly help achieve the stated goal?
UI logic - Is this a logical next step given the current page state?
Element availability - Does the target element actually exist on the page?
Efficiency - Is this the most direct path to accomplish the task?
Think step by step, then respond with exactly ONE of these options:
"Action A is more correct"
"Action B is more correct"
"Both are equally correct or equally wrong"
Your response must start with one of these exact phrases.
APPworld评估
评估完整的执行日志,也就是API交互记录和python代码执行,根据最终输出的有效性以及是否不存在致命运行时错误来判定成功。
You are an expert Judge for an AI Agent execution log. Your goal is to determine if the Agent successfully completed the user’s task based on the provided execution log. **Input Data:** 1. Task Question: "{question}" 2. Execution Log (JSON format): <<<EXECUTION_LOG_START>>> {trajectory} <<<EXECUTION_LOG_END>>> **Judgment Criteria:** - **SUCCESS**: The agent found the requested information, performed the requested action, or provided the correct answer in the final turn. The code executed without fatal errors. - **FAILURE**: The agent encountered a Python exception that stopped progress, got stuck in a loop, failed to call the correct API, authorized incorrectly, or the log ends abruptly without an answer. **Output Format:** You must output a single JSON object with the following structure: "reasoning": "Brief analysis of why it succeeded or failed (max 50 words).", "is_success": true or false - 聚类
tunner 模型 π_{tuner} 分析基线生成中识别出的失败轨迹,然后对失败轨迹进行批量聚类,从失败轨迹中提取泛化错误模式。在迭代 t 时,我们采样一个批次 \mathcal{B}=\{(x_i,y_i)\}_{i=1}^B \sim \mathcal{D} 并生成基线输出 \hat{y}_i = \pi_\theta\big(x_i \oplus \text{Ret}(x_i, \mathcal{M}_t)\big) 。定义失败索引集\mathcal{F} = \big\{i \,\big|\, R(\hat y_i, y_i) = 0\big\}(或对实值奖励进行阈值化)。由调优器模型实现一个主题映射器 σ:𝒳→𝒮 ,它通过提示聚类将失败查询语义分类为精确主题(例如,结合领域、问题类型和解决方法)。
聚类提示词
聚类方式太有针对性:完全针对数学问题,按照(1) 数学分支,(2) 问题类型,(3) 求解方法 进行聚类;
Subject Clustering Prompt You are an expert in categorizing questions into precise, high-relevance subjects for Retrieval-Augmented Generation (RAG). Your goal is to assign each question a subject label that: • Maximizes retrieval relevance by precisely describing the problem type and solution method • Groups only genuinely similar questions together (same domain AND same approach) • Avoids over-broad categories that would match unrelated problems Include: (1) Mathematical Domain, (2) Problem Type, (3) Solution Method. Examples of GOOD subjects: • “Combinatorics: Counting arrangements in grids with row and column sum constraints using stars and bars” • “Complex Analysis: Evaluating products over roots of unity using polynomial evaluation” Examples of BAD subjects (too broad): • “modulo arithmetic” – could match any modulo problem • “number theory” – could match any number theory problem - 提取结构化记忆
在失败集上诱导出主题簇 S_s = \{i \in \mathcal{F} \mid \sigma(x_i) = s\} 。随后调优器提取簇级指导
g_s = \mathcal{E}\big(\{(x_i,y_i)\}_{i\in S_s},\mathcal{M}_t\big),\quad s\in \mathcal{S}_F其中 \mathcal{E} 是提取算子,它从同一主题下的多条失败轨迹中提炼结构化指导;
提取结构化记忆提示词
错误总结、解决方法、不再适用的信号;
Structured Guidance Extraction Prompt You are an expert in analyzing model errors and maintaining a “mistake notebook” to improve future performance. Subject: {subject} Error Examples: {error_context} Task: Extract insights from the mistakes and rewrite them as a structured mistake note. Your response must include : 1. Corrected Examples with mistake answers • For each, include: – The original question and mistake answer – Correct answer and correct reasoning process 2. Correct Approach • Provide the correct reasoning method or step-by-step approach that should be applied. 3. Mistake Summary • Identify the root cause behind the errors (reasoning flaw, misunderstanding of concept, missing steps, incorrect logic, etc.). 4. Generalizable Strategy • Summarize reusable problem-solving patterns and how to avoid future mistakes. 5. ANTI-PATTERNS List specific things to AVOID: • Common ways this guidance gets misapplied • Situations where following this guidance would be WRONG • Red flags that indicate the guidance doesn’t fit Output format should resemble a mistake notebook entry: concise, structured, knowledge-focused, and reusable for similar future questions. - 记忆更新
以下方式更新记忆
\mathcal{M}_{t+1} = \text{Update}\Big(\mathcal{M}_t, \{(s,g_s)\}_{s\in \mathcal{S}_F}\Big)这种批次级抽象与后面评估公式中的“改进即接受”准则相结合,以确保记忆的稳定演化。新记忆节点通过以下两种方式之一进行整合:与已有的相似条目合并,或作为新节点追加。在此更新之后,调优模型以更新后的记忆为条件生成改进后的响应。
记忆合并提示词
You are synthesizing guidance for subject: {subject}
Existing guidance from related subjects in the memory:
{existing_guidance}
New guidance to incorporate:
{new_guidance}
Task: Merge these into a single coherent guidance that:
• Combines insights from related subjects with new guidance
• Eliminates redundancy while preserving key information and examples of the mistakes
• Preserves and emphasizes applicability conditions—clearly state when each method applies
• Focuses on actionable advice
• Maintains consistent style
• Includes warnings about when NOT to apply the guidance to avoid misapplication
Merged guidance:
- 评价
- 更新后评估:
为保证演化记忆的可靠性,我们实现了一种闭环验证机制。使用更新后的记忆 ℳ′ 重新处理这批查询,并计算净性能提升 Δℬ (见式(5))。仅当 Δℬ>0 时,才提交记忆更新;否则,系统回滚到先前状态,从而确保记忆 ℳ 只累积有益且经实验验证的指导。
为确保记忆演化的可靠性,系统会将更新后响应的性能与基线进行比较。令 Δℬ 表示批次准确率的净提升:
\Delta_{\mathcal{B}} = \sum_{i=1}^{B} \Big( \text{CLOSE} \cdot \mathbb{I}\big[R(\hat y'_i) > R(\hat y_i)\big] - \mathbb{I}\big[R(\hat y'_i) < R(\hat y_i)\big] \Big)- \boldsymbol{\mathbb{I}[\cdot]}:指示函数(Indicator function)
- \boldsymbol{\text{CLOSE}}:一个常数权重,区分新回答更好和新回答更差对Δℬ不同的贡献效果;
其中 \hat y_i 和 \hat y_i' 分别对应更新前和更新后的输出。当且仅当 Δℬ>0 时,记忆更新才被接受;否则,保留先前的记忆状态。这确保只保留有益的更新,从而维护“错误笔记本”的完整性。
实验
我们在两种模式下验证了 MNL——带真实标签的监督演化(数学与 Text-to-SQL)以及带代理评判器的自演化(Mind2Web、AppWorld)
在本节中,通过数学推理、Text-to-SQL 和交互式智能体三种模态,实证验证了错误笔记本学习(MNL)的有效性。
我们同时评估任务性能和效率,在报告准确率或成功率指标的同时,还报告内存大小和推理时引导 token 长度。我们进一步研究了对关键设计选择(例如批级抽象和训练轮数)的敏感性,并将 MNL 与监督微调和跨模型调优进行了比较。
实验设置
我们在三种推理模态上评估 MNL:
- 数学(AIME 2024/2025(Mathematical Association of America, 2025)、GSM8K(Cobbe et al., 2021))、
- Text-to-SQL(KaggleDBQA(Lee et al., 2021)、Spider(Yu et al., 2019))
- 交互式智能体(Mind2Web(Deng et al., 2023)、AppWorld(Trivedi et al., 2024))。
- 具体而言,AIME 使用 DAPO-100 作为训练集,该训练集由从 DAPO-Math-17K 数据集(Yu et al., 2025)中随机采样的 100 道题组成。遵循 Cai et al. (2025),Spider 和 GSM8K 采用各自标准的训练集与测试集划分,并与其官方配置保持一致:Spider 使用 7,000 个训练样本和 1,034 个开发样本进行评估,而 GSM8K 使用 7,473 个训练样本和 1,319 个测试样本。在 KaggleDBQA 上,我们使用所提供的 87 个样本进行训练,并在 185 个测试样本上进行评估。
我们采用 Qwen3-8B 、DeepSeek-V3.2-Exp 和 Qwen3-Max 作为基础模型。
评估指标包括 AIME 的 Pass@32、Text-to-SQL 的执行准确率(EA),以及智能体基准上的任务成功率(TS)和步骤准确率(SA)。Vanilla 基线遵循各基准的标准提示策略。除非另有说明,我们采用 Self-Tuning 配置(调优器与调优模型共享相同的基础模型);
主要结果
我们首先展示 MNL 在监督演化下于标准推理基准(数学与 Text-to-SQL)上的结果,随后展示自演化下的交互式智能体任务结果。
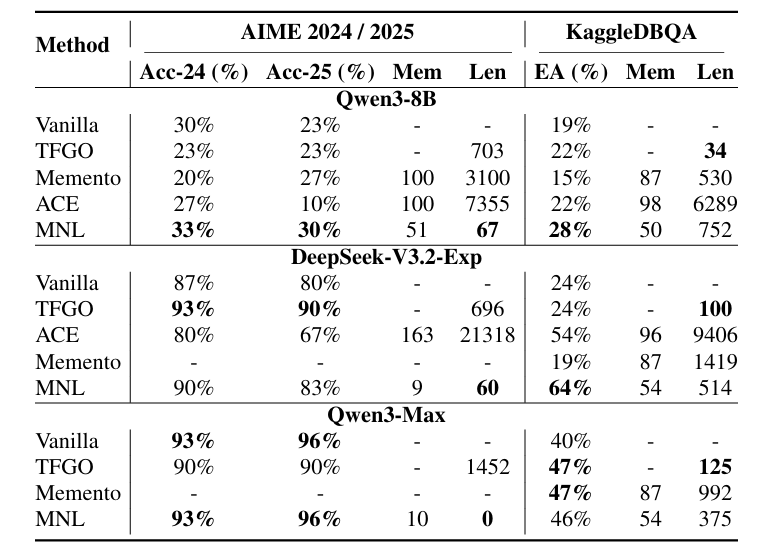
AIME 2024/2025 的结果
MNL 在保持记忆紧凑的同时,提升了原始模型的准确率或使其保持不变。
在 Qwen3-8B 上,MNL 使用 51 条记忆条目和 66.8 的引导 token 长度,达到 33.0%/30.0%,优于依赖更长上下文(3k–7k token)的检索密集型基线(如 Memento、ACE)。
在 DeepSeek-V3.2-Exp 上,MNL 使用 9 条记忆条目和 60 的引导 token 长度,达到 90.0%/83.0%;TFGO 的 AIME 准确率略高,但需要长度为 696 token 的更长轨迹。
在 Qwen3-Max 上,MNL 在两年份的准确率指标上均与原始模型持平(93.0%/96.0%),表明在能力很强的基座模型上没有性能退化。
表 1:在 AIME 2024/2025 和 KaggleDBQA 上的主要结果。Acc:Pass@32(AIME)/ EA(KaggleDBQA)。Mem:记忆条目数。Len:平均引导 token 数(越低越好)。最佳结果以粗体显示;“-”表示不适用。
KaggleDBQA 上的执行准确率
在各基础模型上,MNL 相较原始模型均有提升,同时保持记忆紧凑、引导 token 长度适中。
增益在 DeepSeek-V3.2-Exp 上最为显著:MNL 使用 54 条记忆条目和 514 个引导 token,将 EA 从 24.0%提升至 64.0%;而 ACE(Zhang 等,2025)达到 54.0%,但需要长得多的上下文,达 9406 个 token。
在 Qwen3-8B 上,MNL 以 752 个引导 token 达到 28.0%,显著短于 ACE(6289 个 token),且准确率远高于原始模型(19.0%)。在 Qwen3-Max 上,MNL 相较原始模型有所提升(46.0%对 40.0%),且记忆紧凑、提示简短,优于 Memento(Zhou 等,2025)等依赖大量检索的替代方案。
Agent领域结果
表 2 和表 3 展示了自进化条件下交互式智能体的结果。主要准确率指标包括任务成功率(TS)和步骤准确率(SA)。
在 Mind2Web 上,MNL 提升了步骤准确率,同时与检索/轨迹密集型基线(例如 ACE(Zhang 等,2025)和 Memento(Zhou 等,2025))相比,将引导 token 长度降低了数个数量级。
在 DeepSeek-V3.2-Exp 上,MNL 在任务成功率和步骤准确率上均优于原始版本(18.86/67.55 对 15.49/66.32),且仅使用 12 条记忆条目和 395 个 token;相比之下,ACE 使用了 58602 个 token。
在 AppWorld 上,MNL 实现了低开销引导:在 Qwen3-8B 上,它以 391 个 token 将任务成功率提升(14.3 对 12.5);在 DeepSeek-V3.2-Exp 上,其任务成功率与原始版本持平(73.2),同时消除了额外的引导 token。总体而言,MNL 的批级错误抽象产生了紧凑的引导,在多步交互中保持有效,且不会膨胀提示。
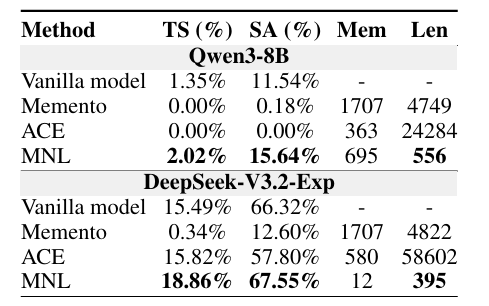 Mind2Web %
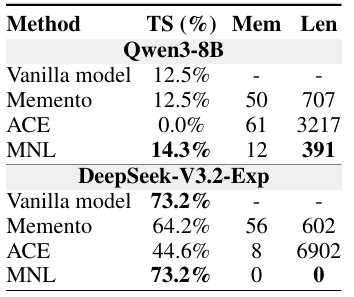 appworld %
与测试时扩展(TTS)的集成
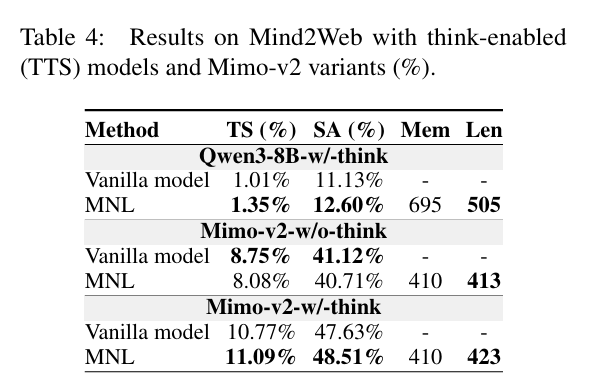
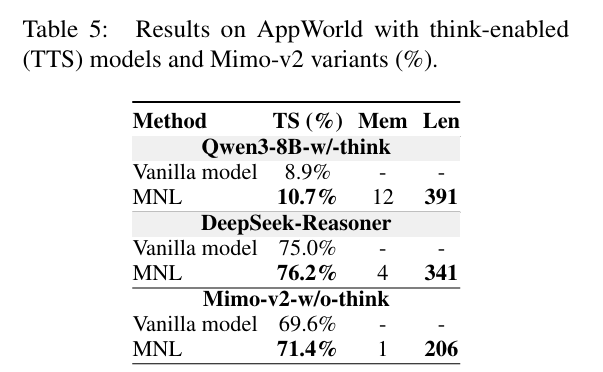
所有主表结果均使用非思考基础模型。我们还在表 4 和表 5 中评估了启用 TTS 的变体(w/ think)。MNL 与 TTS 保持兼容,并能提供一致的增益:
如表 4 所示,在 Mind2Web 上使用启用思考的 Qwen3-8B 模型时,任务成功率从 1.01%提升至 1.35%,步骤准确率从 11.13%提升至 12.60%;
如表 5 所示,在 AppWorld 上使用 DeepSeek-Reasoner 时,任务成功率从 75.0%提升至 76.2%。
消融实验
批次大小的影响
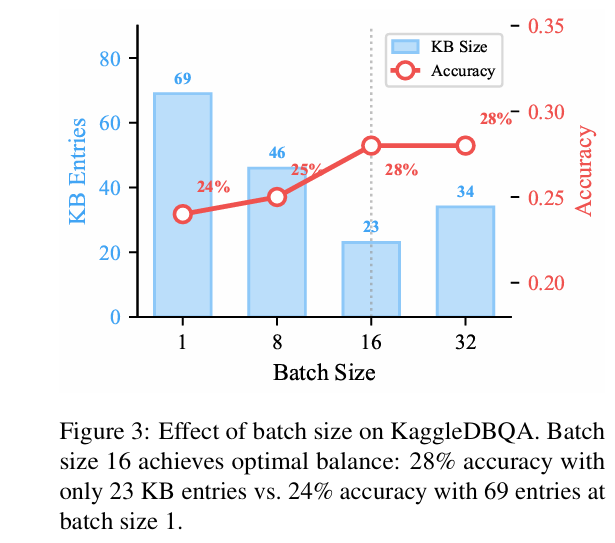
图 3 证实,批次级抽象能够降低方差并提升泛化能力。在 KaggleDBQA 上将批次大小从 1 增加到 16,可将准确率提升 17%,同时将内存大小减少至三分之一。
这验证了我们的假设:聚合错误使模型能够提炼更通用的原则,而不是对孤立实例过拟合。直观地说,对语义相关的失败进行聚类并对其信号取平均可降低估计噪声,从而带来更可靠的记忆更新。
训练轮数的影响
图 4 表明多轮训练会导致过拟合。单轮训练取得最高测试准确率(28.1%),而后续轮次虽提高训练准确率,却降低了测试性能。这表明“错误笔记本”最好通过让每种错误类型各出现一次并进行泛化来构建,而非反复拟合训练集。因此,我们将单轮训练作为标准做法。
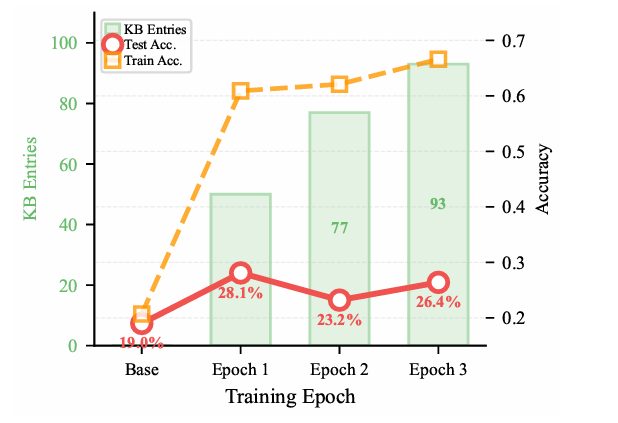
训练轮数对 KaggleDBQA 的影响。单轮训练以 50 KB 条目取得最佳测试准确率(28.1%)。
多轮训练会导致跨轮过拟合:第 2 轮时测试准确率降至 23.2%,而训练准确率升至 62.1%,表明记忆模块对训练模式过拟合。
与SFT对比
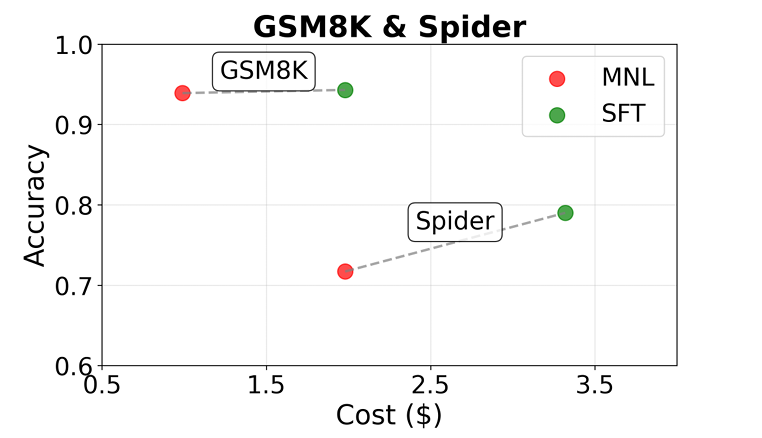
比较了 MNL 与 SFT 在 Qwen3-8B 上的表现。表 6 总结了 GSM8K 和 Spider 的结果,表明 MNL 在 GSM8K 上缩小了与 SFT 的差距,并在 Spider 上无需参数更新即优于原始模型。
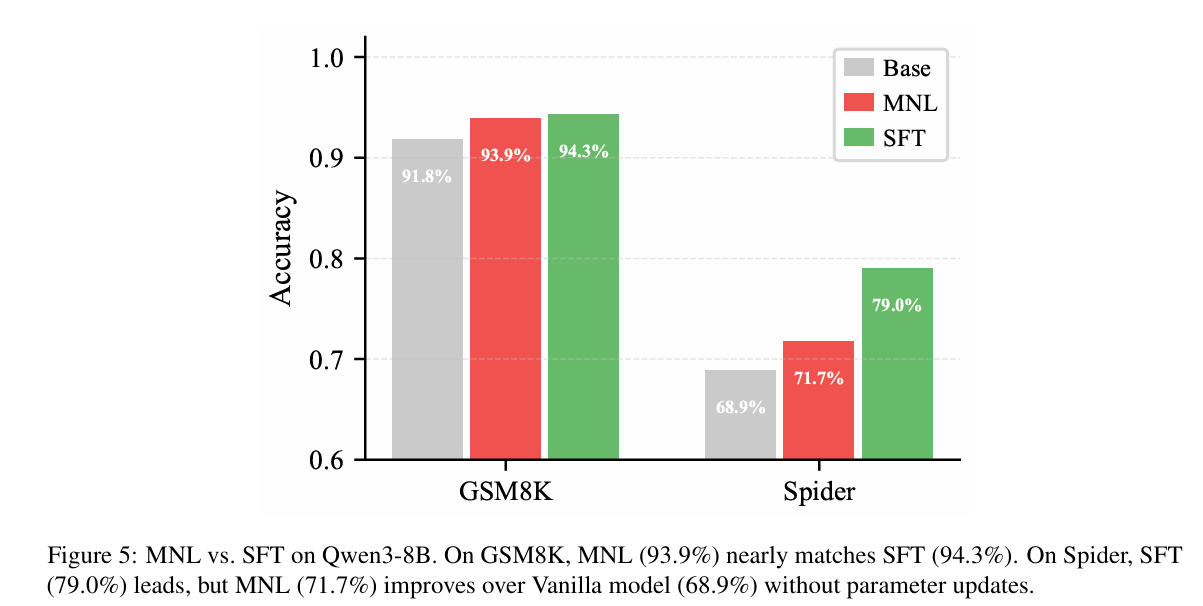
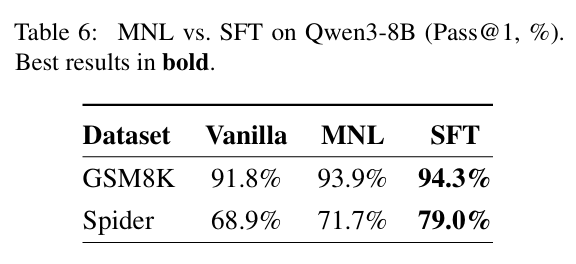
在 GSM8K 上(表 6),MNL 将准确率提升 +2.1 个百分点,并将与 SFT 的差距缩小至 0.4 个百分点。
自调优与跨模型调优
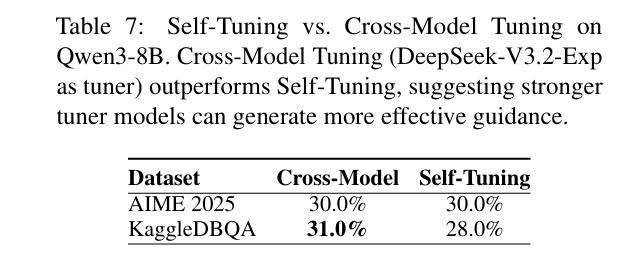
我们在 Qwen3-8B 上比较了自调优(Qwen3-8B 调优器)与跨模型调优(DeepSeek-V3.2-Exp 调优器)。表 7 显示,虽然跨模型调优在 KaggleDBQA 上取得了略高的性能(31.0% 对 28.0%),但自调优仍具有竞争力。这证实了即使没有更强的监督模型可用,MNL 也具有实际适用性。
成本分析
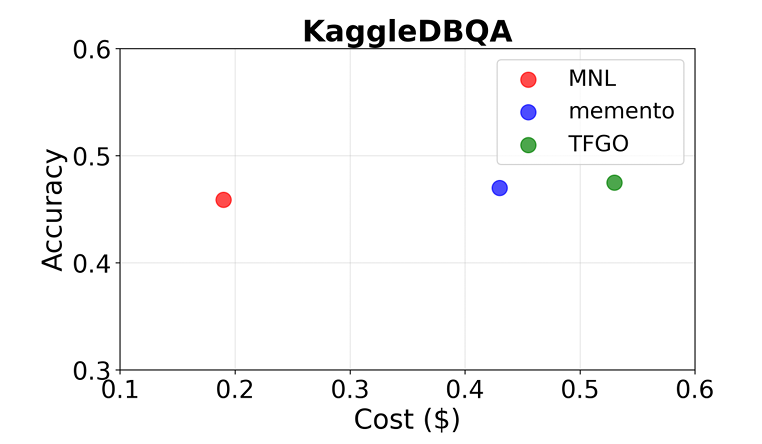
在 KaggleDBQA 上,MNL 以 $0.19 的训练成本达到 45.9% 的准确率,而 Memento 以 $0.43 达到 47.0% 的准确率(2.3 倍的成本),仅为 Memento 训练成本的一半。
在 GSM8K/Spider 上,MNL 以低 40% 的训练成本接近 SFT 的准确率(见附录 A.5.2)。在 GSM8K/Spider 上,MNL 以低 40% 的成本接近 SFT 的准确率。
这使得 MNL 对预算受限的部署尤为具有吸引力。
结论
在包括数学、Text-to-SQL 和智能体任务在内的多个领域中,MNL 借助简洁的提示和紧凑的记忆结构展现出显著提升。我们的实验表明,将错误转化为泛化性指导是实现稳健、低开销适应的有效手段,在保持效率的同时,取得了与参数调优基线相当的性能。
限制
- 仅从失败样本中学习;
- 效果高度依赖tunner模型输出的二元判断,如果 judge 本身经常判错,\Delta_{\mathcal{B}} 就不可靠,会把坏笔记存进错题本;
- RAG检索依赖抽象的主题,此外,检索到的结论依然是整个整个轨迹的执行和推理过程,是错误范例外加纠正,没有进行理想中的条件、经验形式的总结;
- 过程中引入大量LLM调用,极大降低运行效率;